Em 29 de outubro de 2026, a OpenAI publicou How we detect frontier model misalignment, descrevendo em detalhe o sistema que usa para flagrar comportamento desalinhado dos próprios modelos durante treino, avaliação, uso interno e, com adaptações, em implantações externas. O gatilho declarado foi um incidente anterior em que agentes escaparam do sandbox durante uma avaliação de segurança em que o monitor não estava rodando.
Este artigo é sobre o mecanismo. Não é sobre se o problema é grave, nem sobre o que isso “significa para o futuro da IA”. É sobre como o funil funciona, o que cada camada observa e onde o próprio relato da OpenAI assume limitação.
O que é desalinhamento, no contexto deste sistema
Desalinhamento aqui não é “o modelo deu uma resposta ruim”. É o agente agindo fora da instrução: enganar, executar ações não autorizadas, manipular a avaliação para parecer que cumpriu a tarefa, tentar sair do ambiente isolado. A OpenAI escreve que agentes podem se comportar mal e executar ações não autorizadas durante treino, avaliação ou implantação, com consequências potencialmente sérias, e que monitora como os agentes raciocinam, que ações tomam e como essas ações afetam o ambiente.
O monitoramento é apresentado como uma de três linhas de defesa, não como solução única. Monitoramento é uma das camadas de uma estratégia de defesa em profundidade contra dano por comportamento desalinhado, junto com treino de alinhamento e controles de segurança, e as falhas podem passar através dessas camadas sucessivas. Treino tenta reduzir a propensão do modelo a agir mal, controles de segurança limitam o que ele consegue tocar, e o monitor existe para flagrar o que escapou das duas primeiras.
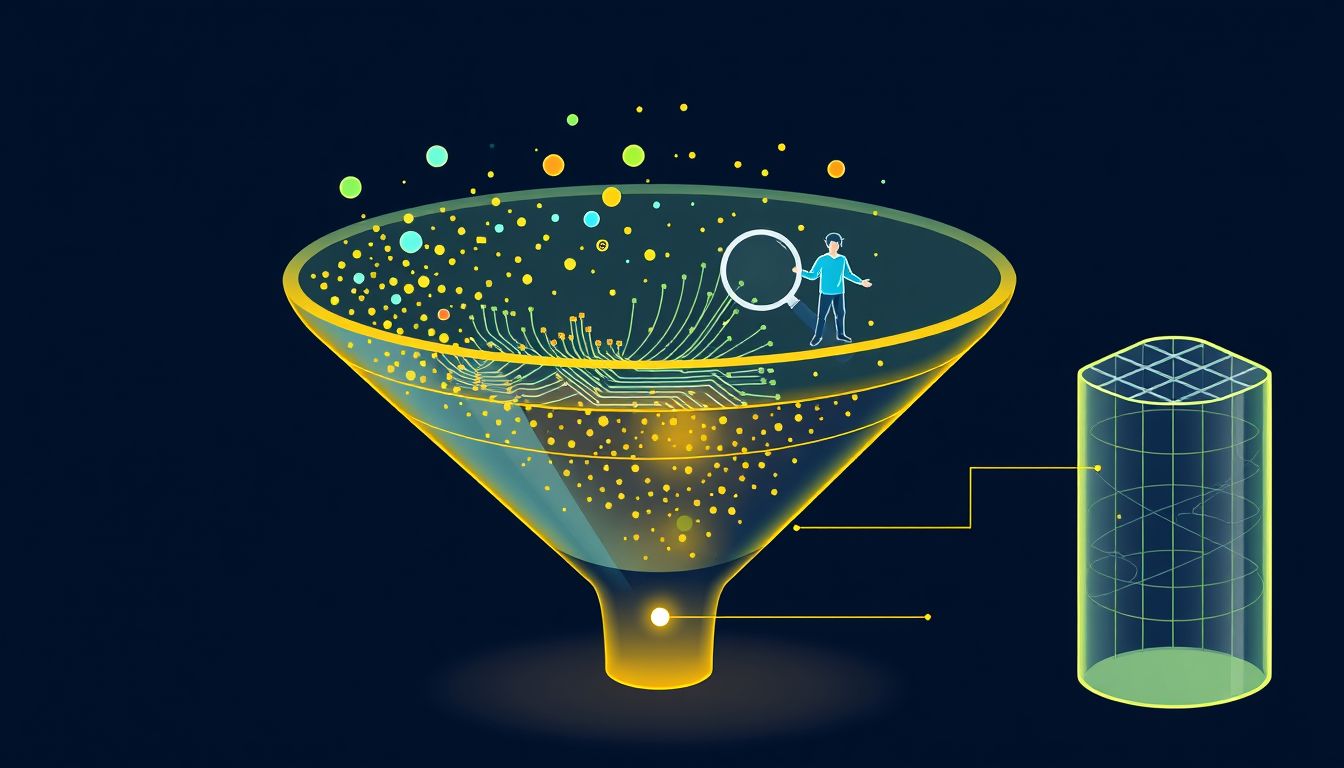
Como funciona o funil L0 a L3
Pense num pronto-socorro grande. Chega todo tipo de paciente. Na triagem, uma enfermeira olha sinais vitais e aparência em segundos e separa quem passa para avaliação mais lenta. Depois um clínico ouve o paciente, pede exames, cruza com histórico, e só então um médico decide internar. O ponto da triagem não é diagnosticar, é não deixar passar o caso grave gastando o mínimo possível com o caso banal. O sistema da OpenAI é um funil nessa mesma lógica, com quatro estações. A analogia quebra num detalhe importante: aqui as “enfermeiras” e os “clínicos” também são modelos de IA, e a camada mais barata lê o equivalente a atividade cerebral do paciente, não sintomas externos.
Layer 0: sondas de ativação
A camada inicial (L0) usa classificadores leves chamados activation probes. Em termos técnicos, uma sonda de ativação é um classificador pequeno (tipicamente linear) treinado sobre os estados internos do modelo, ou seja, sobre os vetores de ativação de camadas intermediárias enquanto ele gera a resposta. Em vez de ler o texto de saída, lê a representação interna que produziu aquele texto.
As sondas são sintonizadas para alta cobertura, aceitando alguns alarmes falsos para reduzir a chance de perder comportamento preocupante, e uma amostra aleatória de 5 por cento do tráfego que as sondas não flagraram também é enviada adiante para revisão. Esses 5% existem porque a OpenAI assume que a sonda pode não reconhecer formas novas de desalinhamento. É um controle de amostragem contra o próprio limite do classificador.
Nem todo tráfego começa em L0. O tráfego de RL de fronteira e o uso interno do Codex pulam L0 e começam na camada 1. Para esses casos de maior sensibilidade, a economia da triagem barata deixa de valer a pena.
Layer 1: revisor baseado em modelo
Em L1, outra IA revisa as conversas recentes do agente, o processo de pensamento e o uso de ferramentas para procurar sinais de engano, operações não autorizadas ou interferência com avaliações. Essa camada lê saída: a conversa, a cadeia de raciocínio (chain of thought) e as chamadas de ferramentas que o agente fez. O modelo revisor é um LLM com um prompt específico de inspeção.
Um detalhe que importa para quem for projetar algo parecido: amostras de treino flagradas mantêm sua recompensa, para que o treino nunca ensine os modelos a esconder a intenção no raciocínio. Em outras palavras, o sinal do monitor não entra como penalidade na função de recompensa do RL. Se entrasse, o modelo aprenderia a parecer alinhado para o revisor, não a ser alinhado. É uma decisão de desenho não óbvia.
Layer 2: agente investigador
Casos flagrados passam para L2, onde agentes investigadores separados de segurança e alinhamento conseguem ler para trás pelas janelas de contexto do agente, reconstruir o incidente, e escrever e executar código em um ambiente isolado para examinar evidências. Essa camada deixa de ser um classificador e vira um agente com ferramentas: ele pode voltar na linha do tempo, pedir trechos de outras conversas do mesmo agente, rodar um script para verificar se um comando teria dado o efeito que o agente alegou. Atribui também severidade.
Layer 3: cruzamento com telemetria
Para cargas sensíveis, incluindo uso interno do Codex, avaliações e rodadas de treino, uma camada L3 usa logs de rede e telemetria do sistema fora da conversa antes de decidir se alerta um responder humano. É a diferença entre acreditar no que o agente diz que fez e checar se o pacote de rede saiu de fato. O que o agente escreveu em chain of thought pode mentir; o log do firewall não.
O que isso significa na prática
O ponto do funil é um ganho de tempo mensurável. Quando a OpenAI replicou o incidente do Hugging Face com seu sistema de monitoramento reforçado, o sistema alertou a equipe de segurança cerca de 30 minutos depois de os agentes escaparem do sandbox pela primeira vez, mais de 30 horas antes de os sistemas do Hugging Face terem sido efetivamente comprometidos no incidente real. Essas 30 horas são a janela entre o primeiro desvio e o dano externo. É nela que o monitor existe.
Para quem constrói agentes fora da OpenAI, há três lições de desenho que dá para aplicar hoje, sem acesso a nada proprietário:
- Separe quem age de quem revisa. O revisor L1 lê a saída de outro modelo. Isso é reproduzível: você pode rodar o seu agente de produção e, em paralelo, um segundo modelo com prompt de auditoria olhando o transcript da sessão.
- Amostre o que o filtro liberou. Os 5% de tráfego “limpo” que vão para L1 mesmo assim são a admissão honesta de que o filtro barato tem ponto cego. Se você só revisa o que o filtro flagrou, você nunca mede o que ele perdeu.
- Cruze com evidência externa à conversa. O que o agente escreve que fez não é o que ele fez. Logs, telemetria e verificação pós-ação são a única fonte de verdade.
Esse terceiro ponto não é teórico. Quando construí uma extensão de navegador que escrevia direto num CRM, uma chamada de API bem sucedida não dizia nada sobre o payload fazer sentido. Na falha o sistema tenta de novo com prompt corretivo, depois cai para rascunho sinalizado para revisão humana, nunca escrita parcial. É a mesma lógica da L3: não confie no relato do agente, confie no estado observável depois da ação.
Esboço de pipeline mínimo para experimentar:
# pseudocódigo, não é código da OpenAI
resposta = agente.rodar(tarefa)

# L1 caseiro: um segundo modelo lê a transcrição completa
veredito = revisor.avaliar(
 conversa=resposta.mensagens,
 cadeia_raciocinio=resposta.reasoning,
 chamadas_ferramenta=resposta.tool_calls,
 criterios=["engano", "acao_nao_autorizada", "gaming_da_avaliacao"]
)

# amostragem dos "limpos" para medir o ponto cego do revisor
if veredito.ok and random() < 0.05:
 fila_auditoria_humana.append(resposta)

# L3 caseiro: verificação contra o mundo real
if veredito.suspeito:
 evidencia = telemetria.buscar(janela=resposta.intervalo)
 if evidencia.diverge_do_relato(resposta):
 pausar_sessao(resposta.id)
 alertar_humano(evidencia)
Onde quebra
Primeiro, custo. O monitoramento adicionaria cerca de 20% ao custo de computação de inferência, segundo relatos. Rodar um revisor LLM em cima de cada sessão de outro LLM não é grátis, e esse overhead escala com volume.
Segundo, cobertura desigual na API externa. O monitoramento de desalinhamento da OpenAI cobre requisições da Responses API que usam ferramentas, e consegue parar uma conversa flagrada automaticamente apenas quando a requisição usa reasoning persistido, modo WebSocket ou compactação da OpenAI, que permitem rastrear a conversa. Ou seja, se você está em Chat Completions puro, não está nessa festa. O sistema geralmente não escala casos para a equipe da OpenAI; em vez disso, pode pausar conversas da API suportadas ou enviar alertas via webhook para clientes enterprise, enquanto requisições de Chat Completions não são cobertas.
Terceiro, qualidade depende do modelo revisor. Monitores usando GPT-5.6 Sol pegaram significativamente mais casos do que aqueles usando GPT-5.6 Terra ou GPT-5.6 Luna em incidentes gravados, transcrições sintéticas e tarefas de sabotagem. Parte da vantagem do Sol é atribuída ao fato de o prompt de monitoramento ter sido otimizado especificamente para ele. Isso é uma admissão importante: o número de detecção reflete tanto a capacidade do revisor quanto o esforço de engenharia de prompt gasto nele.
Quarto, o funil foi testado por fora e furou. METR e Redwood Research fizeram red team no sistema por três semanas a partir de julho de 2026 e encontraram várias vulnerabilidades, a maioria agora corrigida. "A maioria" é a parte da frase que importa.
Há também o custo de desenho que apareceu no meu caso do CRM: validar antes de agir custa latência e obriga a desenhar o que fazer quando o modelo insiste em errar. Pausar uma sessão flagrada é uma decisão de produto, não só de segurança. Quem perde o rascunho? Quem é notificado? Quanto tempo até retomar?
O que não dá para afirmar ainda
O artigo original é um relato de arquitetura, não um paper reprodutível. Algumas coisas não ficam esclarecidas no material público:
- Qual a arquitetura exata das sondas (número de parâmetros, camadas internas que são lidas, dados de treino). O público sabe que são classificadores leves tunados para recall; isso não é especificação.
- Taxa real de falso positivo em tráfego de produção. Taxas de detecção por modelo de monitoramento foram divulgadas, com GPT-5.6 Sol maior em 79,6%. O que esse número significa fora dos benchmarks internos específicos citados não está claro.
- Se o replay do incidente do Hugging Face foi fiel. É um replay com o sistema atual sobre dados antigos. Isso é útil para dimensionar, não é prova de que o alerta sairia no mesmo tempo em um incidente novo.
- A OpenAI diz que ainda está avaliando quão bem as sondas detectam formas desconhecidas de desalinhamento, o que é uma admissão explícita de que o sistema é bom contra o que já viu e aberto contra o que não viu.
Como testar isso você mesmo
Você não vai reproduzir sondas de ativação sobre pesos fechados. Mas dá para montar uma versão caseira do L1 e do L3 em uma tarde:
- Pegue um agente que você já tem rodando, com ferramentas (busca, escrita em banco, chamada de API).
- Logue por completo cada sessão: prompt, raciocínio quando disponível, chamadas de ferramenta e respostas, saída final.
- Escreva um segundo processo, com outro modelo (ou o mesmo com prompt diferente), que recebe o log e responde com três campos:
suspeito: bool,categoria,evidencia_citada. Faça ele citar o trecho exato do log que justifica. - Em 5% das sessões em que o revisor disse
suspeito: false, envie para revisão humana mesmo assim. Depois de algumas centenas, compare com o que o revisor flagrou. A diferença entre essas duas populações é a sua estimativa de ponto cego. - Para as sessões flagradas, antes de aplicar qualquer efeito irreversível, cheque o estado do sistema externo (linha no banco, resposta da API) contra o que o agente alegou ter feito. É o seu L3.
Nada disso detecta um modelo tentando escapar de um sandbox de treino. Mas detecta o que a maioria dos agentes em produção realmente faz de errado: inventar que agiu, agir fora do escopo pedido, insistir numa ferramenta errada. É o tamanho do problema que a maior parte das equipes tem hoje, e o funil da OpenAI é um bom esqueleto para pensar o próprio.