Em 20 de novembro de 2026 a OpenAI publicou o MedChemBench, um benchmark que avalia modelos de IA em tarefas de raciocínio tiradas de pesquisa real em química medicinal. O anúncio descreve o teste como uma forma de medir se modelos conseguem ler estruturas moleculares, interpretar resultados experimentais e escolher quais compostos testar em seguida. Aqui eu quero destrinchar o mecanismo do benchmark, não a manchete do score.
O que o MedChemBench é, em uma frase
É um conjunto de 99 problemas tirados de pesquisa publicada, construído a partir de 117 artigos e patentes, cobrindo 761 estruturas moleculares distintas. O modelo é colocado em um ponto específico de um programa de descoberta de fármacos e precisa raciocinar a partir dali. Cada resposta é uma tentativa única, sem ferramentas, sem feedback, sem experimentos novos.
Como o benchmark funciona por dentro
Em química medicinal existe um problema chato: melhorar uma propriedade de uma molécula costuma piorar outra. Um composto pode grudar lindamente no alvo biológico, mas ser absorvido mal, ou ser quebrado rápido demais pelo fígado. O químico vive negociando esses eixos. O MedChemBench tenta medir essa negociação.
O contexto que o modelo recebe
Antes de qualquer tarefa, o modelo recebe o estado do programa de pesquisa: o alvo biológico, os objetivos do grupo, os compostos estudados até ali e os achados experimentais selecionados. Não é prova de química de vestibular. É um recorte do caderno de laboratório em um dia específico.
Os quatro componentes avaliados
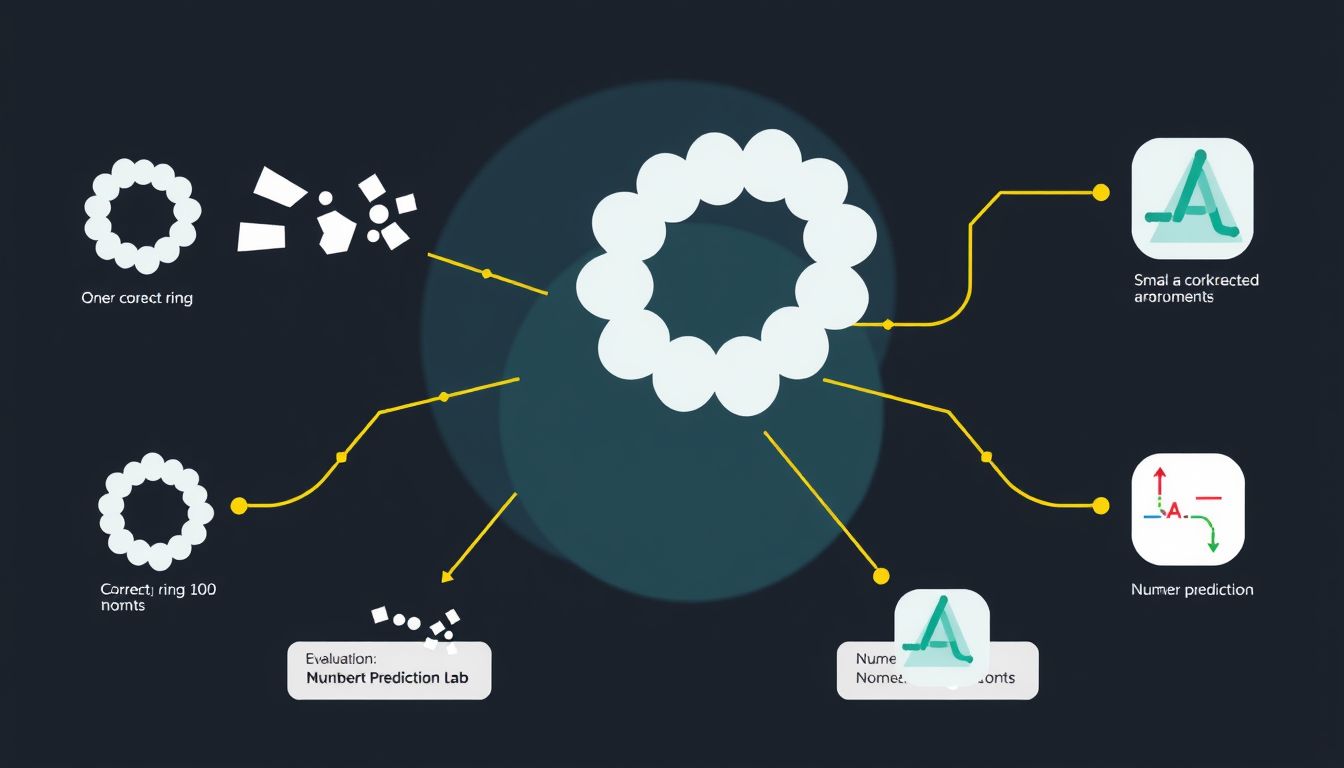
O benchmark separa quatro habilidades: reconstruir moléculas, explicar achados, selecionar compostos e prever medidas. Cada uma pontua separadamente, o que é mais interessante que o número agregado, porque mostra onde o modelo quebra.
- Estruturas moleculares. Conexões corretas entre átomos e estereoquímica especificada, em moléculas montadas a partir dos desenhos e grupos químicos fornecidos.
- Raciocínio científico. Explicações apoiadas pela evidência fornecida, como as razões para preferir um composto a outro.
- Ranking e seleção. Ordenações e escolhas de compostos que atendem aos requisitos declarados.
- Predição de propriedades. Comparação dos valores previstos com os medidos no artigo original, com crédito parcial pela proximidade.
O exemplo PRMT5, passo a passo
Para ancorar o mecanismo, vale olhar um dos problemas reais do benchmark. Ele usa pesquisa sobre inibidores da PRMT5, uma proteína estudada em descoberta de fármacos oncológicos. O fluxo é assim:
- O modelo recebe estruturas de moléculas e resultados de experimentos anteriores.
- O modelo precisa prever, para três compostos relacionados, com que força bloqueiam a PRMT5 nas células, com que facilidade atravessam a barreira celular e com que velocidade enzimas do fígado os quebram em um ensaio de laboratório.
- Os experimentos posteriores, que foram omitidos no prompt, mostram o trade-off: o composto 23 inibiu a PRMT5 em concentração mais baixa, enquanto o 24 cruzou a barreira celular mais prontamente e foi degradado mais devagar no ensaio.
- A resposta é comparada ao resultado experimental real. Previsões numéricas ganham crédito parcial conforme a proximidade.
É aqui que a analogia ajuda, com cuidado: pense em um gerente de produto que recebe três protótipos e tem que adivinhar qual vai ser mais rápido, qual vai consumir menos bateria e qual vai cair menos, só olhando o diagrama de arquitetura. O que o benchmark mede é essa adivinhação informada. A analogia quebra quando você lembra que no diagrama de software uma linha errada ainda roda. Na química, mudar um átomo muda a identidade da molécula.
O componente de reconstrução estrutural
Antes de raciocinar sobre propriedades, o modelo precisa identificar a molécula. Um desenho químico codifica conexões, anéis e estereoquímica. Em um dos problemas, o modelo recebe um núcleo central e dois grupos para acoplar, preservando um anel de 18 átomos. Nas respostas ilustradas pela OpenAI, modelos mais antigos erraram feio: um produziu um anel de 15 átomos, outro quebrou a molécula em dois fragmentos desconectados. Para quem não é químico isso parece detalhe. Não é. É o equivalente a mudar a assinatura de uma função que o resto do código chama. A partir dali, qualquer raciocínio sobre a molécula errada é lixo com formatação bonita.
O que isso significa na prática
Os números reportados pela OpenAI no post, no modo de raciocínio mais alto (xhigh), foram GPT-6.2 Astra com 84,5% do crédito disponível, com os modelos anteriores atrás. Mas o número agregado esconde o ponto interessante: a performance por componente. Em reconstrução de estrutura, o Astra tirou 95,4% no xhigh. Em seleção de compostos e predição numérica, cerca de metade disso.
Traduzindo: o modelo acerta o desenho da molécula quase sempre, explica razoavelmente bem, e erra onde dói, que é decidir qual composto fazer a seguir. Isso é relevante para qualquer um que esteja pensando em usar modelos como copiloto em domínios técnicos.
Nos livros que escrevi, entre eles a série IA na Prática, insisto num ponto que aparece aqui de novo: qualidade média não existe, existe qualidade por eixo. Um modelo que acerta 84% no agregado e 50% no eixo que importa para a sua decisão é um modelo que não resolve o seu problema, mesmo parecendo bom no gráfico.
Se você fosse montar um pipeline inspirado no setup do MedChemBench para um domínio seu, a estrutura do prompt seria algo como:
# contexto do programa
alvo: PRMT5
objetivo: aumentar permeabilidade mantendo IC50 < X nM
compostos_ja_feitos:
 - id: 17, estrutura: <SMILES>, IC50_celular: 12 nM, Papp: 0.8
 - id: 18, estrutura: <SMILES>, IC50_celular: 45 nM, Papp: 6.1
evidencia_selecionada:
 - troca de X por Y reduziu ligacao a albumina

# tarefa
para os compostos 23, 24, 25:
 1. reconstrua a estrutura a partir do nucleo + grupos
 2. preveja IC50 celular, Papp e meia-vida em microssomas
 3. recomende qual sintetizar primeiro e justifique
O importante aqui não é a sintaxe. É a ordem: estrutura antes de predição, predição antes de recomendação. Se você inverter, e deixar o modelo recomendar antes de garantir que a molécula está certa, você vai receber recomendação confiante sobre a molécula errada.
Onde isso quebra
Três limitações são explícitas e importantes.
Contaminação de treinamento. Os problemas vêm de artigos e patentes publicados. A própria OpenAI avisa que exposição prévia às fontes não pode ser descartada e que os papers podem ter estado nos dados de treino. Um modelo pode estar lembrando, não raciocinando.
Tentativa única, sem ferramentas. A avaliação usa respostas de uma única tentativa, sem ferramentas, sem feedback e sem experimentos novos. Nenhum químico trabalha assim. Nenhum agente sério de produção trabalha assim. Então o score mede uma versão mais dura do problema do que a situação real de uso.
É retrospectivo. Por enquanto, o MedChemBench mede raciocínio a partir de evidência histórica. Ele não mostra que o modelo descobriria o fármaco se o experimento ainda não tivesse acontecido. A diferença é a mesma entre explicar uma partida de xadrez já jogada e jogar uma partida nova.
Tem um quarto ponto que não é do benchmark, é do uso prático: o modo de maior esforço de raciocínio custa muito mais tokens, e portanto muito mais tempo e dinheiro, do que o modo normal. A curva de performance versus tokens do próprio paper deixa isso claro. Se você está desenhando um produto em cima disso, o trade-off entre acurácia e custo é real, não é detalhe de fim de parágrafo.
Vale uma anedota aqui. Quando construí uma extensão de navegador que escrevia direto num CRM, descobri na marra que chamada de API bem-sucedida não diz nada sobre o payload fazer sentido. O modelo retornava dado estruturado, válido, parsing feliz, e metade dos campos estava errada. Acabei montando um esquema onde, na falha, o sistema tenta de novo com prompt corretivo, depois cai para rascunho sinalizado para revisão humana, nunca escrita parcial. O MedChemBench é uma versão formal desse mesmo problema: o modelo pode produzir uma estrutura química sintaticamente perfeita que é a molécula errada. Sem uma camada de verificação depois, você não sabe.
O que ainda não dá para afirmar
A própria OpenAI é explícita sobre o que esses números não mostram. Os scores não demonstram que os modelos possam descobrir fármacos ou melhorar decisões de laboratório. Traduzindo: capacidade de reconstruir evidência publicada não é equivalente a capacidade de gerar hipótese nova que sobrevive ao experimento.
Há também um detalhe que confunde quem procura o benchmark em leaderboards agregados. Algumas fontes de terceiros ainda listam MedChemBench como um benchmark interno onde o topo era 49,7%, número que aparecia na página do GPT-6 Astra em versões anteriores. Um dos trackers de benchmarks mostra o GPT-6 Astra em 49,7% como melhor resultado registrado. O post público de 20 de novembro usa uma versão expandida do benchmark e reporta 84,5% para o GPT-6.2 Astra no xhigh. São rubricas e escalas diferentes. Comparar direto é armadilha.
Também não dá para dizer, só com esse paper, se o salto entre gerações se mantém em domínios onde o modelo não viu o artigo fonte. Isso só vai ficar claro em versões futuras do benchmark, com problemas construídos a partir de pesquisa não publicada, ou com holdout temporal verificável.
Como testar isso você mesmo
Você não vai rodar o MedChemBench inteiro em casa. Mas dá para reproduzir o método do benchmark num domínio que você conhece, e isso é o que importa:
- Escolha um artigo técnico recente da sua área, de preferência um que você sabe que descreve um trade-off (duas propriedades que se opõem).
- Monte um prompt que entregue ao modelo só o contexto até certo ponto do artigo: o problema, os dados iniciais, as evidências parciais. Esconda a conclusão e os números finais.
- Peça três coisas, em ordem: reconstruir o objeto principal (estrutura, arquitetura, protocolo, o que couber), explicar o trade-off, prever o valor final.
- Compare com o que o artigo realmente reporta. Pontue cada eixo separado, não um score único.
- Repita no modo de raciocínio mais alto e meça quanto a mais você paga em tokens para quantos pontos a mais você ganha.
Esse exercício ensina mais sobre onde confiar no modelo do que qualquer número agregado. E coincide, por acaso, com o que o MedChemBench está fazendo em escala e com rigor: separar as coisas que o modelo faz bem das coisas em que ele ainda é um advogado eloquente defendendo a molécula errada.