Se você já usou mais de um agente de codificação, provavelmente descobriu que cada um guarda a conversa de um jeito, num lugar diferente, e que trocar de agente no meio do trabalho significa recomeçar. Skillsync ataca essa dor com um conversor de formato de sessão, e a parte técnica que faz isso funcionar é open source.
O que foi lançado, quem lançou e quando
No dia 17 de novembro de 2026 (ontem, na thread do Hacker News), Nars Ganeshkumar e Nishant Joshi anunciaram no Launch HN o Skillsync, batch W26 da Y Combinator. A proposta é resumida na página oficial: tornar sessões de IA portáveis entre agentes e times, local first, sem lock in e sem precisar re-explicar contexto. Por baixo do app desktop existe um motor separado, aberto: o txcript, uma crate Rust que também é publicada como pacote npm e CLI.
Como o txcript converte uma sessão entre agentes
O problema real: cada harness inventou o próprio formato
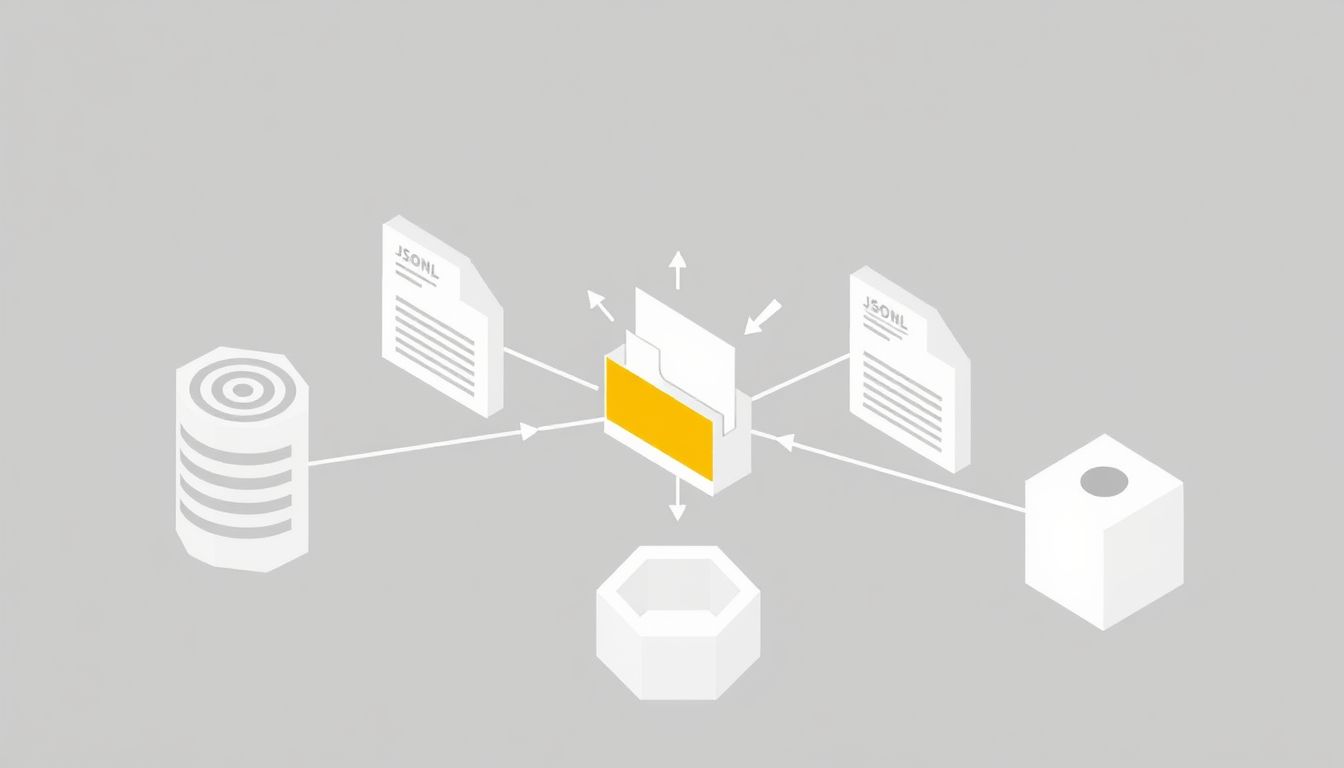
Antes de entender a solução, vale ver o tamanho da bagunça. Claude Code, por exemplo, grava cada sessão como um arquivo JSONL na sua máquina. A documentação oficial confirma: o SDK escreve os transcripts em arquivos JSONL sob ~/.claude/projects/ no filesystem local. Cada linha desse arquivo é um evento: uma linha JSON por vez, onde cada linha é um evento na conversa, uma mensagem enviada, uma resposta do Claude ou uma chamada de ferramenta e seu resultado.
A escolha de JSONL não é estética. O arquivo é append only e escrito uma linha por vez conforme a sessão faz stream. Essa é a razão inteira dele ser JSONL e não um grande array JSON: dá para fazer flush da linha no instante em que ela existe sem reescrever o arquivo, e um crash no meio da sessão ainda deixa você com um arquivo válido até a última linha completa.
Codex também usa JSONL, mas com esquema próprio. Cursor tem outro. Antigravity, OpenCode, Amp, Grok, Hermes, cada um cravou sua estrutura. E a Anthropic é explícita sobre o risco de você tratar isso como API estável: o transcript padrão pode ser armazenado localmente como JSONL, mas seu formato de entrada é explicitamente interno e pode mudar entre releases. Não construa um parser em cima de relações ou tipos de registro não documentados.
Ou seja: os formatos existem, estão no disco, mas ninguém prometeu compatibilidade nem estabilidade. É esse pântano que o txcript aceita atravessar.
A ideia central: um modelo canônico no meio
Pense no que o ffmpeg faz com vídeo. Você tem MP4, MOV, MKV, WebM, cada um com codec e container próprios. O ffmpeg não escreve um conversor específico de MP4 para MOV, outro de MP4 para MKV, outro de MOV para WebM. Se fizesse assim, cada formato novo exigiria N conversores. Em vez disso, tudo passa por uma representação intermediária de frames e streams, e cada formato só precisa saber ler e escrever essa representação. A analogia se paga aqui porque a mecânica é a mesma. Ela quebra se você levar longe demais: sessões de agente carregam semântica (quem é usuário, quem é assistente, qual bloco é reasoning, qual é tool call) que vídeo não tem.
O txcript faz exatamente esse hub central. A documentação da crate explica em uma linha: a crate mapeia cada formato através de Transcript<Common> e converte com convert::<A, B>: A -> Common -> B. Stores preservam o shape nativo em disco. Common preserva semântica de conversa que dá para retomar, não identidade byte a byte.
Traduzindo o passo a passo:
- Store: sabe onde no disco cada harness guarda os arquivos e como ler e escrever no formato nativo, byte a byte.
- Codec: sabe como transformar o texto nativo daquele harness num objeto
Transcript<Common>, e vice versa. - Common: o modelo canônico. Tem common::Message, common::Block, common::Tool e afins.
Para converter uma sessão de Claude Code para Codex, o fluxo é: lê o JSONL do Claude com o Store do Claude, roda o Codec do Claude para produzir um Transcript<Common>, roda o Codec do Codex no sentido inverso para gerar o JSONL do Codex, escreve com o Store do Codex. A garantia declarada é bem específica: round trips byte losless: carregar e salvar uma sessão no próprio formato reproduz ela exatamente. Entre harnesses diferentes a promessa é outra e mais honesta: a conversão cross harness preserva mensagens, reasoning, tool calls, tool results, imagens, metadata e usage onde disponível.
Note o “onde disponível”. Se o alvo não tem lugar para guardar tokens de reasoning, aquilo se perde na tradução, e é por isso que o commom não promete identidade byte a byte entre formatos diferentes.
O modelo hub e a matemática de N para 1
Hoje o txcript declara 16 harnesses, um modelo: cada formato converte através de Transcript<Common>, então adicionar um harness conecta ele a todos os outros. A lista atual inclui, entre outros, Claude Code, Claude Chat, Cowork, Codex, OpenCode, pi, Campfire, Cursor, Grok, Hermes, Amp e Antigravity.
Para quem quer plugar um agente que o txcript nunca ouviu falar, existe uma porta de saída documentada: agentes que o txcript nunca ouviu falar emitem o Simple interchange JSON documentado, um arquivo ou stream entregue ao txcript diretamente, e seus transcripts continuam em qualquer harness suportado. Isso importa porque significa que você não depende do time do Skillsync escrever um adapter para o seu agente proprietário: se ele sabe emitir o Simple JSON, entra na rede.
O que isso significa na prática
O caso concreto que a documentação do próprio txcript coloca na cara é o que mais dói no dia a dia: começar uma sessão no Claude Code, bater no limite de uso ou numa parede, e continuar no Codex com a conversa, o reasoning e o histórico de tool calls inteiros.
Instalação, para quem quer testar em Rust:
cargo install --git https://github.com/skillsynchq/txcript txcript-cliE o uso pelo pacote npm, direto do README:
import { convert, toCommon, fromCommon, harnesses } from "txcript";
import { readFileSync, writeFileSync } from "node:fs";

const input = readFileSync("rollout.jsonl", "utf8");
// native -> native (ex.: Codex -> Claude Code)
Para o app Skillsync existe também um servidor MCP: txcript mcp expõe as ferramentas read only list_sessions, search_sessions e read_session, para que agentes possam minerar sessões passadas como contexto. Ou seja, um agente rodando no seu editor consegue buscar dentro do seu próprio histórico de conversas com outros agentes.
Eu venho puxando essa linha de perto porque nos livros que escrevi, entre eles a série IA na Prática, o tema recorrente é justamente que contexto é a camada onde a maior parte das falhas de agente acontece. Ter o transcript inteiro portável muda o que dá para fazer com contexto passado: em vez de resumir e perder detalhe, você mantém a trilha completa e decide na hora da retomada o que puxar.
Onde quebra
Alguns pontos que a leitura da documentação e da thread deixam claros:
- Semântica portada não é comportamento portado. Mesmo com toda a conversa migrada, o agente receptor pode reagir diferente. Um dos comentaristas na thread perguntou sobre degradação. Um dos fundadores respondeu que Skillsync age como conversor universal, movendo a sessão inteira incluindo mensagens, reasoning e tool calls, mas notou em outra resposta que sessões longas às vezes fazem o agente receptor decidir compactar. O transcript existe e é acessível, mas a janela efetiva do modelo destino manda.
- Formato interno pode mudar sem aviso. Isso é da Anthropic, não do txcript: o formato de entrada do JSONL é explicitamente interno e pode mudar entre releases. Não construa um parser em cima de relações ou tipos de registro não documentados. Quem depende disso em produção precisa aceitar risco de manutenção. O txcript minimiza porque documenta cada formato com proveniência: todo formato on disk de cada harness está descrito em docs/formats/, com proveniência para cada afirmação (docs oficiais, permalinks de fonte ou notas de engenharia reversa).
- Sessões arquivadas do Codex não aparecem sozinhas. Um usuário reportou na thread e o próprio fundador confirmou que ia adicionar suporte. O PR já foi mergeado, mas é o tipo de canto que aparece.
- Common não é identidade byte a byte. Vale repetir porque é o trade off central: Common preserva semântica de conversa que dá para retomar, não identidade byte a byte. Se o seu caso de uso for auditoria forense do transcript original, use o Store nativo, não o Common.
- Subagentes viajam junto? A depender do harness, não é trivial. No Claude Code, por exemplo, se a sessão spawnou subagentes, você também recebe um diretório irmão nomeado com o UUID da sessão, com um arquivo por subagente dentro. Pegar só o .jsonl top level significa ter a thread principal com o trabalho dos subagentes faltando. Vale checar caso a caso o que o Store do txcript coleta.
Do lado do produto, no StartAtende, meu agente de suporte no WhatsApp, o que importa não é só transportar a conversa entre modelos, é decidir o que da conversa vira decisão de produto. Portabilidade de transcript é insumo para isso, não substituto: ter os bytes não significa ter o que fazer com eles.
O que ainda não dá para afirmar
Não testei o Skillsync ponta a ponta em cima de uma sessão de dezenas de MB para medir qualidade real de retomada num agente de destino diferente, então não vou falar de latência ou de fidelidade percebida. Também não sei quão frequentemente Claude Code e Codex vão mudar o formato interno nos próximos meses, e o quanto isso vai gerar churn de manutenção no txcript. A promessa de “16 harnesses” é do repositório, mas a profundidade da cobertura varia por adapter, e a única forma honesta de saber é abrir os arquivos em docs/formats/ do formato que interessa a você e conferir.
Também há um ponto de negócio que a documentação não resolve: o Skillsync app tem workspaces de time onde a sessão sai do disco. A regra declarada é que tudo roda na sua máquina, então seu contexto continua seu, exceto o que você explicitamente compartilha. Qual é a política de retenção nesse compartilhamento, criptografia em repouso, quem no time consegue ler o quê, isso é conversa para o SLA e não para um post de blog.
Como testar isso você mesmo
Um caminho pequeno para experimentar em uma tarde:
- Localize uma sessão sua do Claude Code em
~/.claude/projects/<projeto>/<session-id>.jsonl. Abra no editor e olhe as primeiras linhas para entender o shape. - Instale o txcript pelo cargo:
cargo install --git https://github.com/skillsynchq/txcript txcript-cli. - Rode
txcript view <session-id>para ver o transcript renderizado como texto legível. Isso já valida que o Store e o Codec do Claude Code estão lendo seu arquivo. - Faça uma conversão para o formato do Codex e escreva o resultado. Abra o Codex, rode
codex resume(ou equivalente da sua versão) e veja se a conversa aparece. - Pegue uma sessão que envolveu tool calls (edições de arquivo, execução de shell). Compare o que o Codex “lembra” dela contra o que estava no original. É aí que dá para calibrar quanto de fidelidade a conversão preserva no seu caso.
Se o seu agente não é suportado, olhe a spec do Simple interchange JSON e escreva um exporter mínimo. É a rota mais rápida para plugar algo custom sem esperar um adapter oficial.