Um agente de IA acerta uma tarefa no ensaio e erra a mesma tarefa no dia seguinte, sem nada mudar no pedido. Isso não é bug de código, é uma característica estatística do próprio agente que quase nenhum benchmark reporta. A IBM Research publicou no blog do Hugging Face em 15 de setembro de 2026 um artigo mostrando um diagnóstico específico para esse problema, junto com uma extensão do toolkit open source ALTK-Evolve. O artigo original é Your Agent Aced the Task. Will It Do It Again?, dos times de Evelyn Duesterwald e Vinod Muthusamy.
O número que abre o texto é o que interessa: no benchmark AppWorld, Evolve melhorou a confiabilidade do agente em +8,9 pontos no geral, com aumento relativo de 74% em tarefas difíceis multi-step. Mas o dado novo é outro. Um agente ReAct rodando GPT-4.1 no AppWorld tem 77,4% de acerto médio em 5 execuções, e apenas 53,0% das tarefas passam nas 5 rodadas. A diferença de 24,4 pontos é o que eles chamam de consistency gap.
O que o benchmark esconde: Mean@k, Pass@k e Pass^k
Três métricas parecidas, três perguntas diferentes. Vale fixar antes de continuar.
- Mean@k: roda a tarefa k vezes, tira média. É o “77% de acerto” que aparece na leaderboard.
- Pass@k: mede a probabilidade de que pelo menos uma de k tentativas independentes seja bem sucedida. Métrica otimista, usada em geração de código onde você pode verificar e escolher a boa.
- Pass^k (lê-se “pass power k”): estima a probabilidade de que um agente tenha sucesso em todas as k tentativas independentes. Isso é útil para avaliar consistência e confiabilidade.
A relação matemática é fixa: Pass^k ≤ Mean@k ≤ Pass@k, sempre. E, como observa a τ-bench, para tarefas de agente do mundo real que exigem confiabilidade e consistência como atendimento ao cliente, propõe-se uma nova métrica, pass^k, definida como a chance de que todas as k tentativas i.i.d. sejam bem sucedidas, tomada como média entre tarefas.
Traduzindo em usuário final: Pass@k é “pelo menos um caminho funciona, e eu escolho”. Pass^k é “o mesmo pedido, feito por dois usuários diferentes, tem que dar certo para os dois”. Em produção, quase sempre você quer Pass^k.
Como funciona: distribuições agudas contra distribuições planas
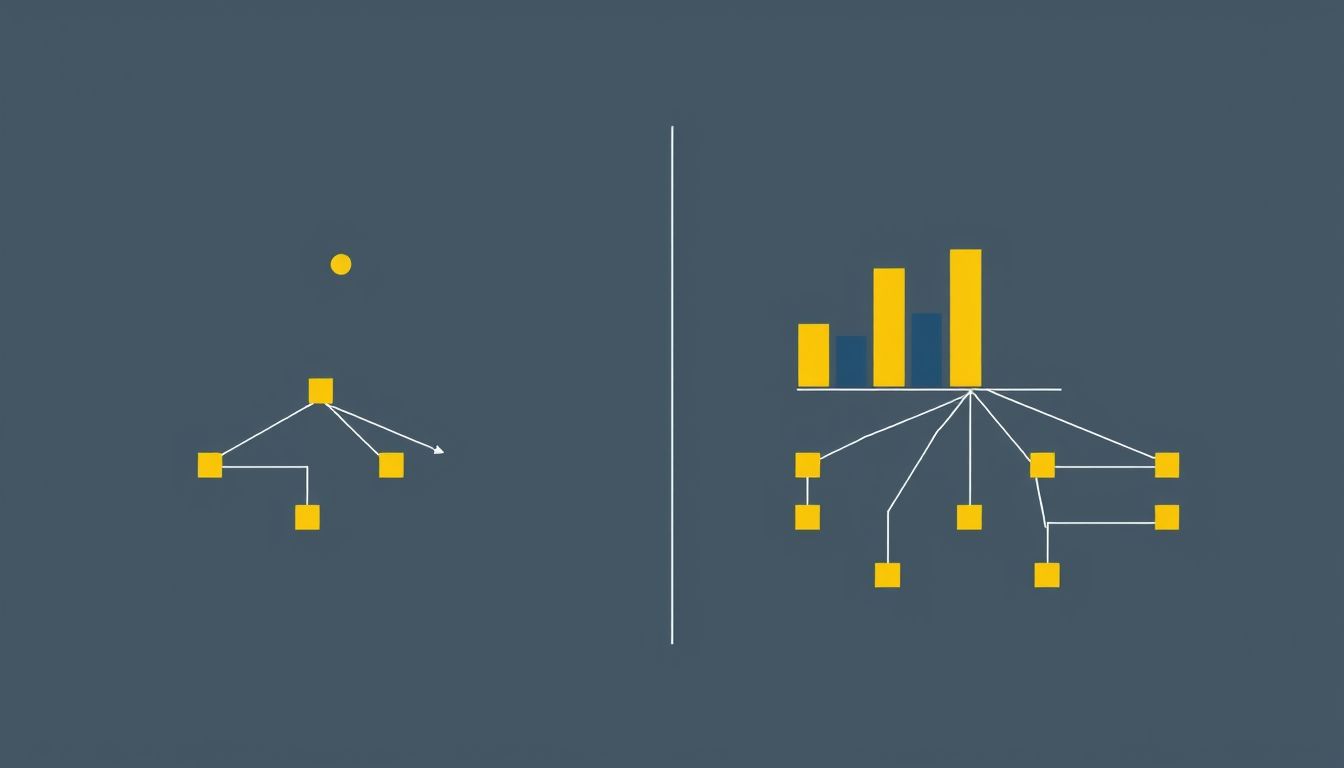
Toda decisão que um LLM toma, qual API chamar, qual argumento passar, se tenta de novo ou não, sai de uma distribuição de probabilidade sobre os próximos tokens. O que decide se a decisão vai se repetir amanhã não é a temperatura, é a forma dessa distribuição.
Pense num juiz de futebol decidindo pênalti. Se a jogada foi um carrinho descarado dentro da área, dez juízes diferentes marcam pênalti. A decisão é aguda: a opção vencedora está muito à frente das outras. Agora, se foi um leve toque no calcanhar com o atacante já caindo, alguns marcam, outros mandam seguir. A decisão é plana: duas ou três opções estão praticamente empatadas, e qualquer pequeno viés (o juiz estar mais cansado, o barulho do estádio) decide para um lado ou outro. A analogia quebra num ponto: no LLM, o “viés” não vem de humor, vem de não-associatividade de ponto flutuante em GPU, de como o batching agrupou seu request, de detalhes do provedor. Mas a mecânica é a mesma: distribuição aguda resiste ao ruído, distribuição plana reordena.
E a trajetória de um agente encadeia dezenas dessas decisões. Uma probabilidade pequena de flipar em cada passo vira uma probabilidade grande de flipar em algum lugar. É daí que sai o gap de 24 pontos.
Consequência prática: temperature=0 não resolve. Decodificação greedy e seed fixo governam como uma distribuição vira um token, não a distribuição em si. No endpoint hospedado, as probabilidades se mexem um pouco de uma execução para outra, e um quase-empate pode resolver para um lado hoje e para o outro amanhã, mesmo com temperatura zero. O experimento da IBM roda a temperatura 0.0 exatamente para deixar claro que o gap medido não é sampling.
O Consistency Analyzer: diagnóstico sem re-executar a tarefa
Aqui está o que muda de arquitetura no ALTK-Evolve. A parte antiga do sistema já era conhecida: um LLM extrai dicas estruturadas (guidelines) a partir de uma trajetória bruta em três categorias, estratégia, recuperação e otimização, agrupa em memória duplamente indexada (embedding mais metadados de categoria/prioridade/contexto/procedência) e as recupera em runtime por similaridade de cosseno ou consulta guiada por LLM. A novidade é o que vem antes disso: um estágio que decide quais guidelines vale a pena extrair, mirando consistência em vez de sucesso.
O pipeline tem dois estágios:
1. Detectar decisões instáveis
Você tem uma trajetória gravada, uma sequência de passos que o agente já executou. O Consistency Analyzer pega cada passo de decisão e faz uma única chamada ao modelo pedindo k completions (k=5 por padrão) sobre o mesmo contexto que já estava registrado. Isso é o ponto crítico da arquitetura: não é rerodar a tarefa inteira, não é chamar as ferramentas de novo, não é interagir com o ambiente. É replay do contexto contra o modelo, offline, uma vez por passo de decisão.
Se as k respostas concordam, o passo é agudo. Se divergem, o passo é plano e vai para uma scorecard. O método é black-box: nada de logits, nada de instrumentação além do trace que você já tem. Isso importa porque, em produção, muitas vezes você não consegue rerodar uma tarefa nem uma vez, o efeito colateral seria real (mandaria e-mail, escreveria no banco, cobraria cartão).
2. Gerar guidelines direcionadas
Cada passo sinalizado vira uma candidata a consistency guideline, no mesmo formato que o ALTK-Evolve já usa. Um exemplo real que o artigo mostra, gerado pelo GPT-4.1 a partir de uma trajetória de contagem de itens em uma nota do SimpleNote:
[Guideline 1] Ao contar marcadores de checkbox no conteúdo
de uma nota, use regex ancorado por linha em vez de contagem
de substring simples; títulos de nota costumam repetir o
símbolo do marcador em uma linha de legenda.

[Guideline 2] Sempre verifique resultados de busca de notas
checando por múltiplos matches e confirmando a nota correta
antes de prosseguir.
Repare que nada disso é trivialidade específica da tarefa. São padrões de decisão que aparecem com alta incerteza em várias tarefas do AppWorld. O analisador mira instabilidade, não falha, então captura passos que o agente acertou desta vez mas poderia errar na próxima.
O que isso significa na prática
Os números do experimento, no AppWorld test_normal (168 tarefas), ReAct com GPT-4.1, gerando guidelines a partir de uma trajetória-base por tarefa e testando em 5 novas execuções:
- Pass^5 agregado: 53,0% → 69,0% (+16,0 pp)
- Mean@5 agregado: 77,4% → 81,0%
- Consistency gap: de 24,4 pp para 12,0 pp
- Easy: Pass^5 de 77,2% para 89,4%
- Medium: 52,1% para 75,0% (+22,9 pp, +44% relativo)
- Hard: 31,7% para 46,0% (+14,3 pp, +45% relativo)
Duas coisas importantes. Primeiro, Mean@5 não caiu em nenhum nível de dificuldade, então o ganho de consistência não veio de trocar acurácia por estabilidade. Segundo, aplicando as guidelines em outra variante do mesmo cenário do AppWorld, o Pass^5 ainda subiu 13,0 pp, três pontos abaixo do ganho na tarefa original. Isso é evidência de que a guideline captura algo transferível, não decora uma trajetória.
Escrevendo nos livros que publiquei, entre eles a série IA na Prática, sobre agentes e engenharia de contexto, o padrão que mais aparece nas dúvidas de leitor é justamente esse: o exemplo do livro funcionou, o mesmo prompt no dia seguinte deu outra coisa. A resposta honesta era “é a natureza probabilística do modelo”. O que essa pesquisa da IBM adiciona é uma maneira de localizar onde a probabilidade está sendo cara demais, sem precisar rerodar a tarefa inteira.
Onde quebra
Custo. Uma chamada extra ao modelo por passo de decisão, com k=5 completions cada, para cada trajetória que você quiser analisar. Se o seu agente executa 30 passos numa tarefa e você quer analisar 100 tarefas, são 3000 chamadas de análise, cada uma retornando 5 candidatas. Não é proibitivo, mas não é grátis, e cresce linear com o tamanho da trajetória.
Escala de janela de contexto. As guidelines aprovadas entram no prompt em runtime, via recuperação por similaridade. Trabalhando com agente de código todo dia, com arquivo de contexto em cada repositório, uma coisa fica clara: contexto demais degrada o raciocínio e multiplica custo ao mesmo tempo. Contexto curado ganha de janela grande. O ALTK-Evolve resolve isso com recuperação, mas ainda cabe a você manter o pool de guidelines enxuto e revisado, principalmente se o modelo por trás mudar.
Efeito em modelos mais fracos é menor em termos absolutos. Com gpt-oss-120b, o ganho de Pass^5 na mesma tarefa foi +6,0 pp saindo de uma base de 10,1%. Curiosamente, a generalização para tarefas similares subiu mais (+8,7 pp) do que na tarefa original, o que sugere que as guidelines estavam pegando padrões de falha reais e não decorando a trajetória específica. Ainda assim, em regime absoluto, um modelo fraco continua fraco.
Depende de você ter trajetórias. O método é diagnóstico sobre traces que já rodaram. Se o seu agente é novo e nunca rodou nada em ambiente parecido com produção, você não tem o insumo.
O que ainda não dá para afirmar
O experimento reportado é em AppWorld com ReAct e GPT-4.1, mais uma corrida secundária com gpt-oss-120b. Não temos dados aqui de como o método se comporta em agentes com arquiteturas diferentes de ReAct, nem com modelos com raciocínio explícito (reasoning traces longas), nem em benchmarks fora de AppWorld. Existe uma issue do repositório mencionando resultados que colocam o agente altk-evolve em #1 no domínio de retail no τ²-bench, mas essa é uma submissão em curso e vale acompanhar antes de generalizar.
Também não está esclarecido, no material público, qual é a taxa de falsos positivos do Consistency Analyzer, quantos passos ele marca como planos que na verdade nunca flipariam em produção. E a análise depende do próprio LLM ser razoavelmente calibrado ao ser resamplado; se o modelo tem viés sistemático, o analisador vai herdar esse viés.
Como testar isso você mesmo
Caminho mínimo, sem depender do toolkit da IBM ainda, apenas para sentir o problema no seu agente:
- Pegue 10 tarefas reais que seu agente resolve. Rode cada uma 5 vezes com o mesmo prompt e o mesmo modelo, temperatura 0.
- Calcule Mean@5 (média da taxa de acerto) e Pass^5 (fração das 10 tarefas em que as 5 execuções passaram).
- A diferença entre os dois é o seu consistency gap. Se for maior que 10 pontos, você tem o mesmo problema descrito no artigo.
- Para uma tarefa que flipou, olhe as trajetórias lado a lado e identifique o primeiro passo em que elas divergem. Esse é um candidato a decisão plana.
Se quiser ir para a ferramenta:
- Repositório: github.com/AgentToolkit/altk-evolve. O ALTK está sob licença Apache 2.0.
- Documentação: agenttoolkit.github.io/altk-evolve.
- Artigo original no HuggingFace: huggingface.co/blog/ibm-research/altk-evolve-consistency.
O que fica é uma métrica que você deveria reportar internamente mesmo sem adotar o toolkit: junto de qualquer taxa de acerto médio do seu agente, o Pass^k correspondente. É a diferença entre “parece capaz” e “pode ser cobrado”.