Em 18 de novembro de 2026, o time da Dharma-AI publicou no blog da Hugging Face um preview do artigo Predicting End-to-End Fine-Tuning Time for Generative Language Models, que vai sair no arXiv. Eles pegaram 272 jobs reais de supervised fine-tuning (SFT) do pool de produção em NVIDIA H200, cerca de 7.382 GPU-horas no total, e compararam estimativas analíticas contra preditores aprendidos. A conclusão é direta: a conta de FLOPs que quase todo mundo usa para estimar duração de treinamento não explica o que acontece num cluster compartilhado, e um modelo treinado com features conhecidas antes do dispatch chega perto do tempo real.
Este post é sobre o mecanismo. O que a conta de FLOPs assume, o que ela ignora, e por que um regressor aprende a corrigir isso.
A conta de FLOPs que a gente usa, e o que ela está dizendo
Para um Transformer denso, a estimativa canônica é que treinar custa aproximadamente 6·P·D operações de ponto flutuante, onde P é o número de parâmetros e D o número de tokens de treino. Divide isso pelo throughput que suas GPUs entregam e sai um tempo de loop de treino:
T_teorico = (6 · P · D) / (N_GPU · FLOPS_peak · MFU)N_GPU é a quantidade de GPUs, FLOPS_peak é o pico da ficha técnica, e MFU (Model FLOPs Utilization) é a fração desse pico que o treino de fato alcança. A MFU tipicamente fica entre 30% e 60%, e o valor certo para um job específico não é conhecido de antemão (o número depende de tráfego de memória, comunicação e eficiência de kernel).
Essa fórmula descreve bem o loop de otimização. O problema é que um job não é só o loop.
O que a conta de FLOPs não enxerga
Pense num voo comercial. O tempo entre decolagem e pouso é só uma parte do tempo total porta a porta. Antes tem taxiamento, fila na pista, espera por autorização. Durante o voo tem desvio por tráfego. Depois tem taxiamento até o portão, esteira, bagagem. Se você só olha o tempo no ar, erra o horário em que a pessoa chega em casa, e erra sistematicamente para menos.
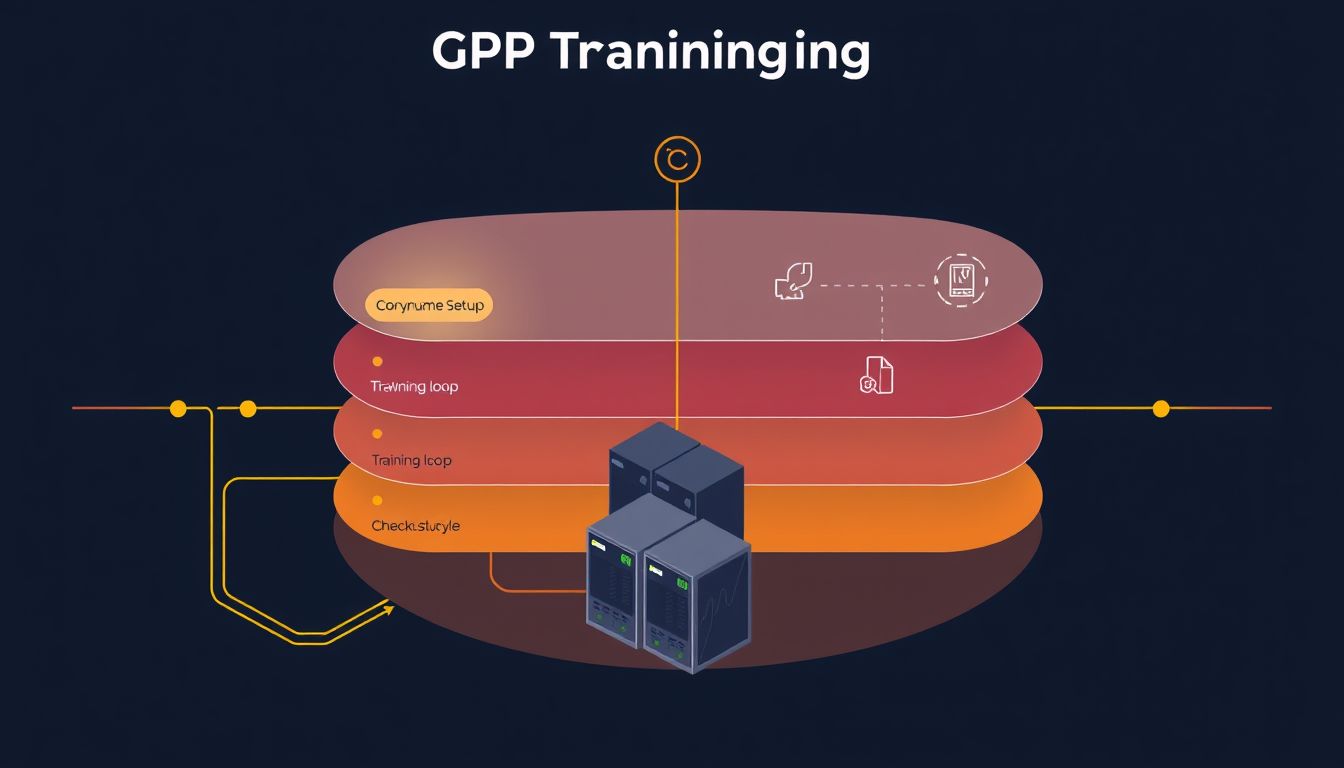
No fine-tuning acontece o mesmo. Fora do loop de treino existem etapas que consomem tempo real: setup de ambiente, download e carregamento do modelo, tokenização, avaliação periódica, upload de checkpoints e escrita do modelo final no object storage. Num cluster multi-tenant, todas essas etapas disputam rede e I/O com outros jobs rodando ao lado.
A analogia quebra em um ponto importante: no voo, taxiamento e esteira são relativamente previsíveis. Num cluster compartilhado, o custo de I/O depende de quem mais está consumindo rede e disco naquele momento. É variância, não offset fixo.
O que o regressor aprende em cima disso
O time da Dharma trata a duração ponta a ponta como um problema de regressão supervisionada. A entrada é um vetor de features construído a partir da configuração submetida do job (hiperparâmetros, tamanho do dataset, identificador do modelo, alocação de GPU) e metadados. Nada de log em tempo real, nada de progresso parcial. Isso é o que permite usar a predição para escalonamento: tudo é conhecido antes do job entrar na GPU.
Em cima da configuração crua, derivam features que expõem o overhead: num_eval_data (amostras processadas somando todos os ciclos de avaliação), num_saves e num_params_saved (I/O de checkpoint), volume de tokens por GPU. A própria estimativa de FLOPs, com MFU fixada em 0,45, entra como uma feature chamada baseline_time, para o modelo partir do número compute-only e aprender as correções.
Compararam Linear Regression, Ridge, XGBoost e CatBoost. Seleção de feature combinou filtro por correlação, informação mútua e permutation importance ao longo de 18 conjuntos candidatos, seguida de grid search com MAE como critério. O modelo final de CatBoost usa 24 features.
Os números, e por que a diferença é tão grande
Todos os resultados vêm de validação cruzada estratificada em 5 folds. Resumo:
- FLOP baseline, MFU 30%: R² = 0,31, MAE 12,41 h
- FLOP baseline, MFU 45%: R² = 0,18, MAE 13,01 h
- FLOP baseline, MFU 60%: R² = 0,01, MAE 14,62 h
- Calculon (modelo analítico de Isaev et al., SC’23): R² = -0,51, MAE 20,36 h
- Ridge: R² = 0,73, MAE 7,23 h
- XGBoost: R² = 0,97, MAE 1,95 h
- CatBoost: R² = 0,98, MAE 1,71 h
Três coisas importam aqui.
Não existe uma MFU mágica que conserta a baseline. Eles varreram MFU de 0,25 a 0,65. O melhor ajuste, 30%, deixa um erro médio acima de 12 horas em jobs que duram 23 horas em média. É um erro da mesma ordem de grandeza do que você está tentando medir.
Um modelo analítico mais detalhado também não resolve. Calculon é um modelo analítico parametrizado de performance para treino de LLMs baseados em Transformer, implementado em Python, originalmente desenhado para explorar co-design de hardware e software. Recebe três especificações (arquitetura do LLM, estratégia de execução com paralelismo e otimizações, e descrição do sistema de hardware) e produz predição de tempo e utilização de recursos, em formato similar ao de um profiler. A equipe estendeu a implementação pública para cobrir LoRA, grouped-query attention, attention fundida, bfloat16 e SwiGLU. As estimativas ainda correspondem a uma mediana de apenas 11% do tempo de wall-clock observado. Isso não é crítica ao Calculon, que foi feito para modelar o passo de otimização, não o job inteiro. É o tamanho do que acontece fora do passo de otimização numa produção real.
O ganho principal vem de gradient boosting. Modelos lineares com as mesmas features chegam a MAE 7,23 h. CatBoost e XGBoost caem para a casa de 1,7 a 2 h. A relação entre configuração e duração tem interações não lineares que um modelo linear não captura.
No que o modelo se apoia
A importância de feature do CatBoost se concentra em poucas variáveis. Primeiro vem num_eval_data, o total de amostras processadas em avaliação ao longo da vida do job. Depois num_trainable_params, batch_eval_size_percent, num_all_params e a interação num_gpus*batch_train_percent, com num_params_saved logo atrás. A frequência com que você avalia, o tamanho do conjunto de avaliação e quantos checkpoints você persiste, tudo isso dá forma ao tempo de wall-clock, ao lado de escala de modelo e dataset.
Uma ressalva importante de leitura: alocações maiores de GPU aparecem com contribuições positivas ao tempo previsto, mas no dataset deles jobs maiores tendem a rodar em mais GPUs. num_gpus funciona parcialmente como proxy de escala do job. Não significa que adicionar GPU deixa um mesmo job mais lento.
O que isso significa na prática
Se você escalona treinos, a utilidade é direta: antes do job sair da fila, o scheduler já tem uma duração estimada com erro mediano de meia hora em jobs curtos e cerca de uma hora em jobs médios, e consegue decidir quais rodam juntos, quando as GPUs vão liberar, se um run cabe antes do deadline.
Se você só treina modelo esporadicamente, o aprendizado é outro: a configuração de avaliação e checkpoint é um dos maiores determinantes da duração, e você está mexendo nisso no automático. Avaliar a cada 100 passos com um split grande, salvar checkpoint toda época, subir pesos completos para storage, cada uma dessas decisões custa horas. O default do Trainer do Hugging Face não está tentando economizar seu tempo, está só rodando o que você pediu.
Um check prático antes do próximo job:
# quanto tempo a avaliacao vai consumir ao longo do run?
num_eval_data = eval_samples * (total_steps // eval_steps)

# quantas vezes voce vai escrever pesos no storage?
num_saves = total_steps // save_steps

# tamanho do que vai para o storage por save
# full fine-tuning: num_all_params; LoRA: so o adapter
Se num_eval_data está na mesma ordem do seu volume de treino, sua avaliação está pesando tanto quanto o treino. Pode ser intencional, pode não ser.
Aqui eu puxo uma experiência que conecta com o primeiro item da lista de features. Já trabalhei analisando texto aberto de avaliação de cliente para decidir feature, usando NLP antes da onda atual de LLM. O padrão que aprendi lá vale para qualquer agregado: a métrica agregada esconde o caso extremo, que costuma ser o que importa. No preditor da Dharma, os jobs acima de 60 horas pesam pouco na MAE média, mas são justamente onde o erro explode. Média baixa não é promessa de que o seu próximo job vai estar perto da média.
Onde o preditor quebra
A honestidade da equipe sobre os limites é o que faz o trabalho ser útil, então vale listar.
Cauda longa de duração. Os erros ficam baixos até 60 horas e abrem bastante acima disso. Para jobs entre 60 e 175 horas, o erro absoluto mediano salta para 5,19 h e o P90 vai a 18,51 h. São 13 runs nessa faixa, contra 192 nos intervalos abaixo de 30 horas. É escassez de dados, e eles mesmos dizem que mais dados ainda estão ajudando (MAE em holdout cai de 1,63 h para 1,50 h quando o particionamento de treino vai de 85% para 100%, sem patamar claro).
Só SFT. Não cobre RLHF, DPO, RLVR ou outras estratégias de alinhamento. A estrutura temporal de um loop de DPO é diferente, com geração de pares, e nada garante que as mesmas features capturem bem a duração.
Um tipo de GPU. Tudo rodou em H200. O modelo está calibrado para essa infraestrutura, e os autores dizem que não deve transferir numericamente para outras gerações sem retreino. Para um pool misto, o modelo precisaria de descritores de hardware (throughput, capacidade e banda de memória, topologia de interconexão) como entrada.
Interpretação causal. Importância de feature em CatBoost não é afirmação causal. Mostra sobre o que o modelo apoia a predição, não que mexer naquela variável vai mudar o tempo na direção prevista.
Um comentário meu sobre custo de adoção, vindo de outra arena. Já publiquei design system e style guide de interface completos, e a conta que fiz na época vale aqui também: investimento desse tipo só se paga quando tem mais de um time consumindo. Um preditor desses, com pipeline de features, log de execução, retraining periódico, é infraestrutura. Se você tem um time rodando dez fine-tunings por mês, provavelmente não compensa construir. Se você opera um cluster compartilhado com dezenas de jobs diários e GPU ocioso custa caro, a conta muda.
O que ainda não dá para afirmar
O artigo completo ainda não saiu no arXiv. As fórmulas exatas das features derivadas, o procedimento de seleção completo, os espaços de busca de hiperparâmetros e o CatBoost final vão estar lá, segundo a equipe, mas ainda não pude ler. Qualquer afirmação sobre reprodutibilidade fina depende dessa publicação.
Também não dá para dizer que o método transfere para outros stacks sem teste. O trabalho usou Transformers da Hugging Face e Unsloth, modelados como feature categórica. Para TRL com configuração de DPO, para Axolotl, para Megatron, você precisaria repetir o pipeline em cima dos próprios logs.
E não dá para extrapolar ganho de scheduling a partir do erro de predição. MAE menor não vira automaticamente utilização maior de GPU. O ganho real depende de quanto o scheduler consegue compactar a fila com a informação melhor, e isso é um experimento separado.
Como testar isso você mesmo
Um caminho pequeno, se você tem histórico de jobs de fine-tuning num lugar só (MLflow, Weights & Biases, um CSV):
- Para cada job, extraia da config submetida: número de parâmetros do modelo, parâmetros treináveis (full vs LoRA), tokens de treino, tokens por GPU, número de GPUs,
eval_steps, tamanho do eval set,save_steps, tamanho do que é salvo. - Derive
num_eval_dataenum_savescomo no bloco de código acima. - Calcule
baseline_timecom a fórmula de 6·P·D e MFU 0,45. Inclua como feature. - Y é a duração wall-clock entre o momento em que o job pegou GPU e o fim. Exclua tempo de fila.
- Rode um Ridge e um CatBoost com 5-fold CV. Compare MAE contra a sua baseline atual, que provavelmente é FLOPs ou um chute de engenheiro.
Se o seu dataset é pequeno (digamos, menos de cem jobs), não espere R² alto. O exercício útil é ver quais features aparecem no topo da importância. Se for num_eval_data e política de checkpoint, você acabou de descobrir onde está perdendo tempo de GPU.
Leitura de base
- Dharma-AI, Why your fine-tuning job takes longer than the FLOPs say, blog Hugging Face, 18 nov 2026.
- Isaev, McDonald, Dennison, Vuduc. Calculon: a Methodology and Tool for High-Level Codesign of Systems and Large Language Models, SC’23. Implementação em github.com/calculon-ai/calculon.