A Nielsen Norman Group abriu a inscrição para a edição virtual de janeiro de 2027 da UX Conference, com cursos online ao vivo entre 19 de janeiro e 1 de fevereiro. Entre os 29 cursos do catálogo, um chamou atenção por mudar de categoria o que normalmente seria assunto de engenharia: Context Engineering: Shaping AI-Generated Designs. É a NN/g dizendo, com todas as letras, que design system e documentação de UX agora também são insumo para modelo de linguagem, e que isso virou disciplina ensinável.
Neste artigo, explicarei o que é context engineering aplicado a design, como o mecanismo funciona por baixo, o que muda na prática quando você adota isso, e onde quebra. O anúncio é só o gancho.
O fato: o curso novo dentro de um calendário já conhecido
A agenda de janeiro repete o formato que a NN/g vem usando desde 2020: aulas no Zoom, ferramentas de colaboração como edição de documento em grupo e quadro branco, e Slack para conversa antes, durante e depois do evento. Cada curso tem 3,5 horas de aula em dois dias consecutivos. A estrutura de certificação segue a mesma: cinco cursos, cinco exames, escolhidos de uma seleção que cobre design de interação, gestão de UX e pesquisa.
O que é novo é a trilha de Inteligência Artificial. Ela não está lá como enfeite: aparece em pelo menos sete cursos distintos ao longo do evento, incluindo AI for Design Workflows, Designing AI Experiences, Accelerating Research with AI, AI Product Strategy e o que me interessa aqui, Context Engineering: Shaping AI-Generated Designs.
A ementa oficial do curso é direta sobre o objetivo: aprender context engineering para transformar pesquisa de UX e padrões de design em materiais reutilizáveis que guiam interfaces geradas por IA e melhoram a qualidade do design em toda a organização. Em outras palavras, pegar o que já existe de documentação de produto e empacotar de um jeito que um modelo consiga usar como referência ao gerar tela, componente ou copy.
Como context engineering para design funciona por baixo
Antes de qualquer coisa, vale separar três termos que a própria NN/g pede para distinguir no curso: UX context design, context engineering e prompt engineering, e como cada um encaixa na construção de produtos com IA.
Prompt engineering é o que você escreve no campo de texto. Context engineering é tudo o que o modelo vê antes do seu prompt: instruções permanentes, arquivos de referência, histórico, documentos recuperados por busca. Uma definição boa, de um curso adjacente, resume assim: context engineering é decidir o que um modelo de IA vê quando responde, suas instruções permanentes, arquivos de contexto, histórico de conversa, documentos recuperados e o próprio prompt.
Pense em dar briefing para um designer júnior novo no time. Você não manda só a tarefa (“faz uma tela de checkout”). Você manda o briefing junto com o design system, o guia de voz, as regras de acessibilidade, exemplos de telas aprovadas antes, a lista do que não pode. Sem esse embrulho, o júnior vai entregar algo coerente com o que ele aprendeu antes de chegar, não com o que o seu produto exige. O modelo de linguagem é esse júnior, só que com memória que zera a cada sessão. O limite da analogia: o júnior pergunta quando não entende, o modelo chuta com confiança.
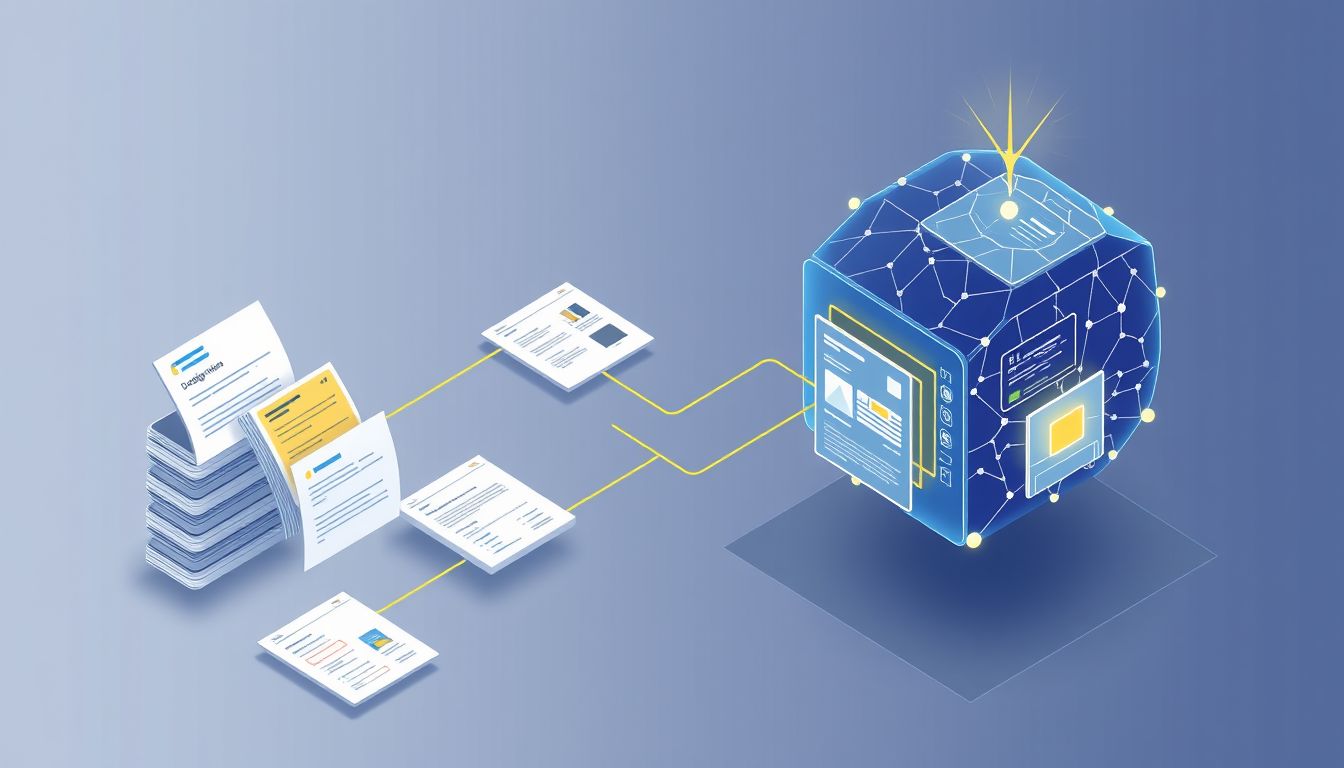
O mecanismo técnico, então, não é mágica. É um pipeline que precisa de três coisas funcionando juntas:
1. Materiais de contexto estruturados
Design token em JSON, regras de componente em markdown, exemplos de código do design system, decisões de arquitetura de informação documentadas com o motivo da decisão, não só a decisão. A NN/g deixa claro no público-alvo do curso: profissionais de design system e design operations criando documentação reutilizável para trabalho de produto assistido por IA.
2. Sistema de recuperação
O modelo não aguenta o design system inteiro no contexto. Você precisa de um mecanismo que, dado um pedido (“gerar modal de confirmação de pagamento”), traga só os pedaços relevantes: regras de modal, token de cor de estado perigoso, padrão de copy para ação destrutiva. Isso normalmente é RAG (retrieval augmented generation), base vetorial mais busca semântica. Fora do escopo do curso da NN/g em detalhe técnico, mas é o encanamento por trás.
3. Manutenção contínua
E esta é a parte que quase ninguém faz. Um artigo recente da própria NN/g sobre como power users gerenciam isso traz a lição central: deixar o agente atualizar o contexto, com algumas atualizações pedidas manualmente e outras disparadas automaticamente por workflows ou outros arquivos de contexto. Contexto é código vivo. Se trava, apodrece.
O que isso significa na prática
Na prática, context engineering para design transforma arquivos que ninguém lê (o PDF do brand book, o Figma que só o designer sênior sabe navegar) em algo que o modelo consome. O formato importa muito.
Um pedaço de documentação útil para humano costuma ser inútil para modelo. Compare:
# Ruim para IA: prosa solta
Nossos botões primários devem transmitir confiança e ação.
Use cor de destaque da marca e evite usar em telas com muitos
elementos competindo por atenção.

# Bom para IA: regra verificável com exemplo
## Componente: Button, variante primary
- cor de fundo: token color.action.primary (#1A56DB)
- padding: 12px 24px
- uso permitido: ação principal única por tela
- uso proibido: dentro de tabela, dentro de card com mais de
 uma ação, em formulário com mais de 3 campos obrigatórios
- exemplo aprovado: /examples/checkout-confirm.tsx
- exemplo rejeitado: /examples/dashboard-grid.tsx (motivo:
 compete com outras CTAs)
O segundo formato funciona porque é literal, enumerável e tem exemplo com motivo. O modelo não precisa interpretar “transmitir confiança”. Ele precisa saber qual token, qual padding, quando usar e quando não usar.
Eu posso falar disso com alguma propriedade porque já publiquei design system e style guide de interface dentro de um dos projetos que mantenho. É um trabalho que quase nenhum engenheiro de IA faz, e é por isso que quase toda interface de produto com agente é feia: a IA escreve HTML sem ancorar em componente, porque ninguém deu componente para ela ancorar.
Onde isso quebra
Primeiro limite, e é econômico: design system só se paga quando tem mais de um time consumindo. Se você é um dev solo com um produto, escrever contexto formal para IA pode custar mais do que o ganho. O mesmo vale aqui. Context engineering vira investimento sério quando você tem múltiplas superfícies (web, mobile, email transacional, documentação) gerando interface com assistência de IA. Com uma superfície só, prompt direto resolve.
Segundo limite: contexto pesa. Cada token que entra no contexto é token que o modelo processa, é latência e é custo. Enfiar o design system inteiro a cada chamada é inviável. É por isso que o artigo da NN/g sobre bibliotecas de contexto insiste em dar aos agentes apenas o contexto de que precisam. Um sistema de recuperação ruim entrega contexto demais, o modelo se confunde, a qualidade cai.
Terceiro limite, e aqui falo de uma dor concreta: dar liberdade de montagem para fora do time de produto significa aceitar saída fora do padrão, a menos que o próprio sistema imponha o limite. Trabalhei em um construtor de landing page que tirou a criação de página da fila da engenharia, com redução de mais de 70% no esforço de desenvolvimento por página. Ótimo número. O preço foi aceitar que marketing ia montar página fora do design system, e a única forma de conter isso era o próprio builder bloquear combinação inválida. Com IA gerando design a partir de contexto é igual: ou o pipeline valida a saída contra as regras, ou você vai ter botão primário em lugar que não devia, de novo e de novo. Context engineering sem gate de validação é documentação cara.
Quarto limite: o curso é caro. A conferência vai de 19 de janeiro a 1 de fevereiro e um curso individual sai na faixa de 1.225 a 1.325 dólares, dependendo de quando você se inscreve. Faz sentido se você vai operacionalizar design system assistido por IA em escala. Para estudar o conceito, o conteúdo público da NN/g sobre context libraries já cobre boa parte do raciocínio de graça.
O que não dá para afirmar ainda
A NN/g descreve objetivos e público do curso, mas não publica o material de aula e não permite gravação (a conferência depende de interação ao vivo e atividade em pequenos grupos em breakout rooms, e por isso gravação não é oferecida). Então eu não sei quais ferramentas específicas eles vão demonstrar, se vai haver exercício prático com API de modelo, nem qual o nível técnico esperado da turma.
Também não dá para afirmar que context engineering aplicado a design vai se consolidar como disciplina. Hoje é tendência forte, com oferta brotando em vários lugares (Hugging Face, DeepLearning.AI, eCornell e outros têm cursos no tema), mas nenhuma dessas ementas chegou a um padrão. É provável que em dois anos a parte técnica (RAG, memória, retrieval) esteja empacotada em framework e o que sobre seja a parte de documentação, que é exatamente onde a NN/g está apostando.
Como testar isso você mesmo
Antes de pagar curso, dá para experimentar o mecanismo em uma tarde:
- Escolha um componente do seu produto, qualquer um. Botão, card, modal.
- Escreva a regra dele em markdown no formato enumerável, com token, com uso permitido, com uso proibido, com um exemplo aprovado e um rejeitado com motivo.
- Abra o Claude, ChatGPT ou Cursor e cole esse markdown como system prompt ou arquivo de projeto.
- Peça para gerar três variações de tela usando esse componente.
- Depois peça a mesma coisa sem o contexto, só o pedido.
- Compare as saídas. A diferença entre as duas é, em miniatura, o que context engineering faz.
Se a diferença for grande o suficiente para justificar formalizar isso em escala, você já sabe se o curso da NN/g vale ou se o que você precisa é de um encanamento de RAG em cima do seu design system. Provavelmente dos dois, em ordem.