Em 28 de outubro de 2026, a OpenAI publicou um customer story sobre a Legora, descrevendo a empresa como construtora de um “agentic operating system for legal work”. O texto público é curto e, por isso, este artigo é mais cauteloso que o normal: vou explicar só o que a arquitetura descrita pela própria Legora, pela Microsoft e pela OpenAI permite afirmar, e marcar com clareza o que ainda é especulação.
O fato, primeiro
Em 28 de outubro de 2026, a OpenAI publicou um customer story sobre a Legora, enquadrando a plataforma da empresa de legal AI como um “sistema operacional agêntico” para trabalho jurídico. O texto diz que a Legora usa modelos da OpenAI, ChatGPT e Codex para acelerar fluxos jurídicos, ampliar análise de contratos e permitir que advogados gastem mais tempo em tarefas de maior valor.
A Legora é sueca, lançou a plataforma em outubro de 2024, mudou de nome de Leya para Legora em 19 de fevereiro de 2025, e é usada por mais de 100.000 profissionais em mais de 1.800 departamentos jurídicos e escritórios de advocacia em mais de 50 mercados. O customer story da OpenAI em si é um resumo. Para entender o mecanismo, é preciso cruzar com a documentação técnica anterior da Legora com a Microsoft e com a página de produto da empresa.
Como funciona a arquitetura, até onde a documentação deixa ver
Antes de entrar nos componentes, uma analogia que carrega a mecânica. Pense num escritório onde um sócio recebe um pedido do cliente, repassa pedaços para associados diferentes (um faz pesquisa de jurisprudência, outro extrai cláusulas de contratos, outro redige), e depois junta tudo numa resposta assinada. O sócio não escreve cada linha, ele decide quem faz o quê, confere, e manda para fora. A arquitetura descrita pela Legora funciona nessa divisão: um orquestrador decide quais ferramentas chamar, cada ferramenta roda uma tarefa específica, e o advogado humano fica no papel de quem confere e assina. A analogia quebra num ponto: o “sócio” aqui não aprende com o caso do jeito que um humano aprende, cada corrida é independente, e a memória entre matérias depende de como o escritório configurou os playbooks.
A camada de orquestração
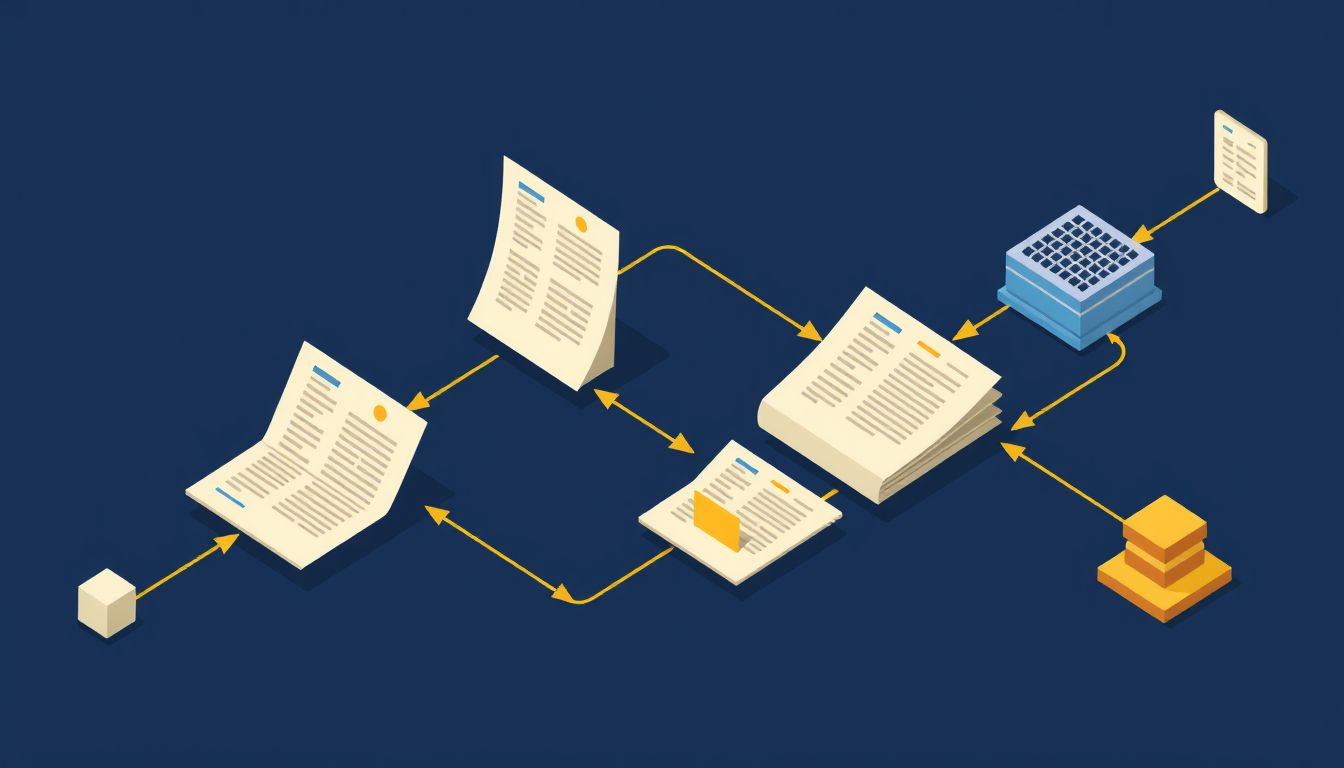
A própria página de produto da Legora chama Workflows de “the orchestration layer for legal work” e descreve o mecanismo: os Workflows são totalmente agênticos e construídos sobre um framework no qual agentes de IA raciocinam e executam tarefas jurídicas complexas passo a passo, seguindo lógica e aplicando a expertise do escritório. Em termos práticos, uma “workflow” é uma sequência declarada de passos (ler estes documentos, extrair estas cláusulas, comparar com este playbook, redigir esta minuta) na qual cada passo pode invocar uma ferramenta nativa da plataforma.
As capacidades nativas (Tabular Review, Legal Research, Translation, Drafting e Database search) são parte de um sistema maior conectado, e cada workflow chama as capacidades certas para entregar soluções end-to-end. Isso é importante por um motivo técnico: significa que o orquestrador não está pedindo para o modelo “fazer tudo” num único prompt gigante. Ele está roteando subtarefas para componentes especializados, o que reduz o espaço de erro de cada chamada.
Os componentes especializados
O que a documentação pública descreve como “ferramentas” tem funções bem concretas. O Tabular Review transforma pastas grandes de contratos, acordos ou materiais de caso em uma grade interativa onde cada documento vira uma linha e prompts gerados por IA correspondem a colunas, permitindo extração de dados-chave, comparação de cláusulas e identificação de inconsistências em escala, seja analisando centenas ou milhares de documentos. Isso é um padrão de map-reduce clássico adaptado para LLM: você aplica o mesmo prompt a N documentos em paralelo e consolida em tabela.
O Assistant é a camada conversacional. Permite que advogados interajam com documentos internos e externos em qualquer idioma, fazendo perguntas e recebendo respostas que incluem citações de fonte. “Com citação de fonte” aqui é a parte técnica relevante: é um sistema de RAG (Retrieval-Augmented Generation), não geração solta.
Como o modelo se encaixa
O customer story da Microsoft, de 2025, descreve a stack subjacente com mais detalhe que o da OpenAI. A Legora usa várias tecnologias, como comportamento multi-agêntico, Retrieval-Augmented Generation (RAG) e paralelização em larga escala de chamadas de API aos LLMs. A paralelização é o que viabiliza a tabular review em grande volume: você não roda 500 documentos em sequência, roda em lotes concorrentes.
Vale notar que a plataforma é alimentada por Azure OpenAI e combina uma ontologia jurídica e um citador de IA para eliminar alucinações. Ou seja, por cima do modelo há uma camada estruturada que mapeia conceitos jurídicos, e por baixo há um sistema de verificação de citações. O modelo bruto não é a resposta final, é um dos passos.
O papel do Codex no ciclo de desenvolvimento
O customer story da OpenAI menciona Codex entre os produtos usados pela Legora. Pelo que o resumo deixa claro, o Codex entra no desenvolvimento interno da plataforma, não no runtime do produto. O resumo diz que o uso de IA pela Legora vai além do produto que ela vende, mas o texto completo com os detalhes não ficou acessível para esta análise. Então: Codex como ferramenta de engenharia da própria Legora é o que o material sustenta, qualquer afirmação além disso é especulação.
O que isso significa na prática
Para quem vai construir algo parecido, o ponto mais importante é a decisão de arquitetura: um pipeline multi-agente com orquestração explícita e ferramentas especializadas, em vez de um prompt monolítico. Trabalhei em algo estruturalmente análogo num sistema multi-agente de captura e enriquecimento de lead, com orquestração explícita em vez de framework, porque quando quebra você precisa saber exatamente qual passo quebrou. Escrever a orquestração na mão custa tempo no começo e devolve em depuração, especialmente quando o cliente aparece com um caso onde a saída está estranha e você precisa reconstruir o rastro.
Um esqueleto mínimo de workflow nesse estilo, só para fixar o mecanismo, ficaria assim:
# pseudocódigo de orquestração explícita
workflow = [
 ("retrieve", {"source": "dms", "query": input.matter}),
 ("tabular_extract", {"docs": "$retrieve.out", "columns": playbook.clauses}),
 ("compare", {"table": "$tabular_extract.out", "against": playbook.standard}),
 ("draft", {"findings": "$compare.out", "template": playbook.memo}),
]

for step, args in workflow:
 result = tools[step].run(args)
 log(step, args, result) # rastro para depuração
 context[step] = result
O ponto que a documentação da Legora reforça, e que vale para qualquer um construindo nessa linha, é que cada passo tem entrada e saída tipadas, e o log de cada passo é o que torna o sistema auditável. Num contexto jurídico, auditabilidade não é feature, é requisito.
Onde quebra
Primeiro ponto, o óbvio: paralelização em larga escala de chamadas a LLMs custa dinheiro e tem limites de rate. Rodar tabular review em milhares de documentos exige acordo comercial com o provedor de modelo e um sistema de retry/backoff bem feito. O material público não diz quanto a Legora gasta por matéria, e sem isso qualquer estimativa de ROI é chute.
Segundo, RAG com citação não é prova de ausência de alucinação. É redução. O modelo pode citar uma fonte corretamente e ainda interpretar errado o conteúdo dela. A Legora reconhece isso ao posicionar a ferramenta como apoio e manter o julgamento final com o profissional: a Legora usa Astra para melhorar precisão, completude e confiabilidade, mantendo o julgamento final com os profissionais do direito. Qualquer sistema multiagente que você construir em domínio regulado precisa dessa linha explícita.
Terceiro, orquestração explícita custa tempo. É o trade-off real: você ganha depuração, perde velocidade de iteração no começo. Para uma pessoa fazendo um protótipo de fim de semana, framework pronto compensa. Para um sistema que vai processar documento jurídico em escala, o custo inicial se paga.
Quarto, integração com o estoque legado do cliente é onde a maior parte dos projetos trava. A Legora investe pesado nisso, conectando a iManage, NetDocuments, SharePoint, Microsoft 365, sem projeto de migração, e isso não é detalhe, é metade do produto. Modelo bom sem integração não vira workflow.
O que não dá para afirmar ainda
Esta é a seção honesta. O customer story da OpenAI em si foi capturado só como resumo. Fontes de cobertura confirmam a limitação: o extrato disponível da página da OpenAI dá o título, mas nenhum texto de artigo que o acompanhe, não fornece data de publicação nem linha do tempo, não dá relato de releases de produto anteriores, e não diz o que o sistema faz, quais tarefas jurídicas ele é desenhado para apoiar, ou se clientes podem usá-lo.
O que isso significa: as métricas mencionadas no resumo (95%+ de redução no tempo da equipe jurídica da Legora revisando NDAs, 90% mais rápido no turnaround de contrato para um cliente Fortune 100, 9,5 horas devolvidas por advogado por semana) vêm do próprio texto da OpenAI/Legora e não foram verificadas de forma independente neste material. Trate como declaração do fornecedor.
Também não dá para afirmar com o que foi capturado: qual é o modelo exato por trás de cada ferramenta hoje, como o roteamento decide quando usar modelo caro versus modelo barato, se há fine-tuning específico ou só prompting, e qual a latência real por workflow. Nada disso aparece com clareza no resumo público. Quem for construir um sistema análogo vai precisar decidir cada um desses pontos no próprio projeto, sem copiar da Legora.
Como testar isso você mesmo
Para experimentar a mecânica (não o produto da Legora, a mecânica de orquestração multiagente com RAG e saída auditável), um caminho curto:
- Pegue 20 PDFs de contrato (podem ser templates abertos de NDA).
- Escreva um script que, para cada PDF, extrai o mesmo conjunto de campos via chamada de LLM (prazo, lei aplicável, cláusula de confidencialidade, exceções). Isso é seu Tabular Review mínimo.
- Rode as 20 chamadas em paralelo com um limite de concorrência (comece com 5).
- Para cada campo extraído, exija que o modelo devolva também o trecho exato do contrato que fundamenta aquele valor. Isso é sua camada de citação.
- Compare duas rodadas: uma com um prompt único pedindo tudo, outra dividindo em dois agentes (um extrai, outro valida contra o texto original). Meça divergência.
Se você fizer isso, vai sentir no osso por que a arquitetura multiagente com orquestração explícita existe, e também por que ela custa mais que a versão monolítica no primeiro dia. Essa é a decisão de engenharia que está por trás do rótulo “agentic operating system”.