No dia 17 de setembro de 2026, a OpenAI publicou o anúncio do Astra for Law, uma configuração do modelo GPT-6 Astra voltada para trabalho jurídico. O material oficial está em openai.com/index/astra-for-law, e o produto foi coberto no mesmo dia por veículos como LawSites, Legal IT Insider e Artificial Lawyer.
O fato, em uma frase
A OpenAI apresentou o Astra for Law como uma nova base para escritórios de advocacia e empresas de legal tech construírem produtos e fluxos de trabalho em cima da sua expertise, combinando o GPT-6 Astra com configurações, ferramentas e contexto ajustados para trabalho jurídico profissional. O lançamento foi em 17 de setembro de 2026, inicialmente oferecido a escritórios selecionados através do programa Trusted Access da OpenAI dentro do ChatGPT e do Codex.
Como funciona
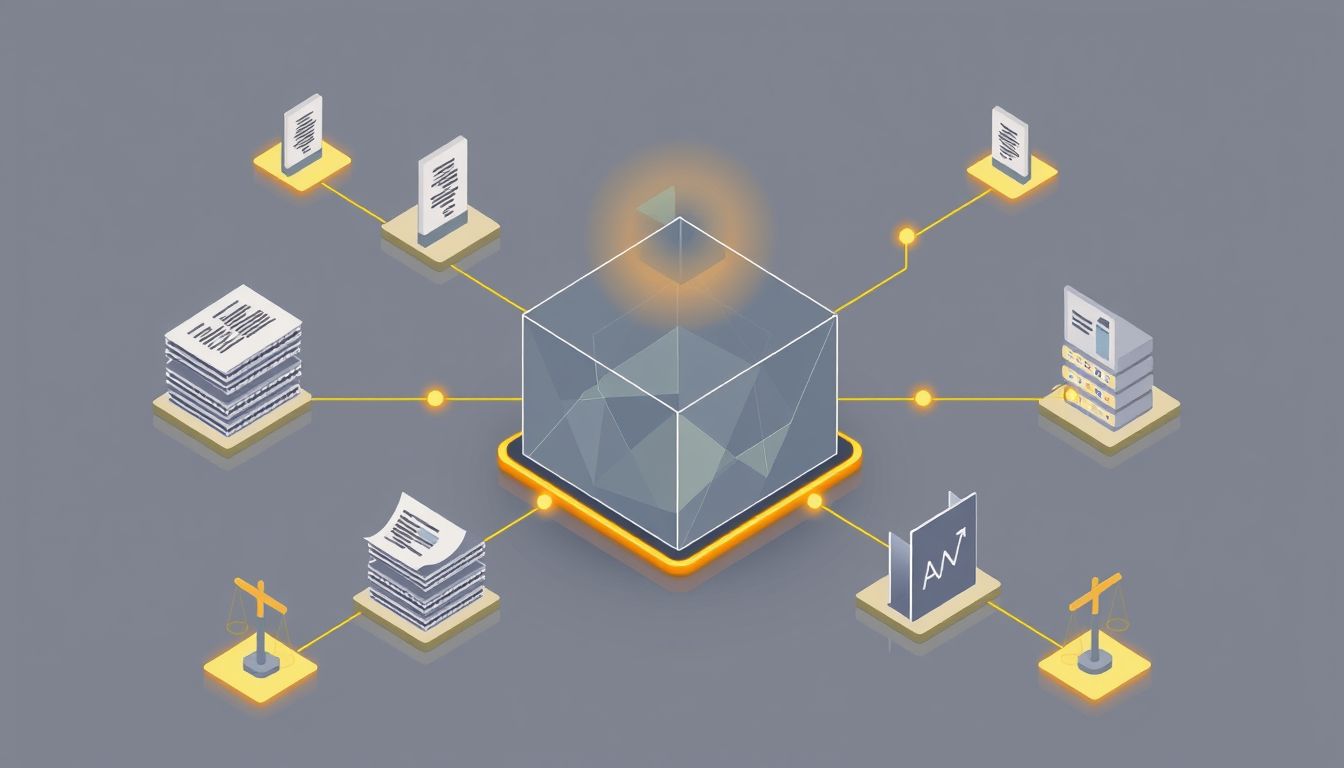
Astra for Law não é um modelo novo treinado do zero. É o GPT-6 Astra com três camadas ligadas a ele. Vale entender cada uma separadamente, porque é aí que está o mecanismo.
Camada 1: instruções e configurações padrão
A OpenAI descreve o produto como GPT-6 Astra combinado com um índice de busca jurídica poderoso e instruções para análise e escrita jurídica. Ou seja, existe um system prompt e um conjunto de defaults que fazem o modelo se comportar de forma diferente do ChatGPT genérico: mais cauteloso ao afirmar, mais propenso a citar fonte, mais rigoroso ao distinguir dictum de holding, provavelmente ajustes de temperatura e de esforço de raciocínio (o que eles chamam de settings for thorough work). O anúncio não detalha o conteúdo dessas instruções.
Camada 2: o índice de busca jurídica
Essa é a parte com mais substância técnica documentada. Usando o índice de busca jurídica, o Astra for Law pode pesquisar case law, estatutos, regulamentos, regras de tribunais e decisões administrativas dos Estados Unidos em um corpus de mais de 230 milhões de URLs, com fontes adicionadas diariamente.
Pense no índice como uma biblioteca separada do modelo. O modelo em si não decorou 230 milhões de documentos; ele tem uma ferramenta que consulta esse acervo em tempo real e traz de volta trechos relevantes para usar na resposta. É o padrão RAG (retrieval augmented generation) aplicado a um corpus jurídico específico. A ideia declarada é ajudar na parte da pesquisa jurídica que começa com encontrar a autoridade exata, localizar as passagens relevantes e entender o quão relevantes e vinculantes elas são para a situação em questão.
Analogia útil, com o limite dela: é como um estagiário que não guarda a lei na cabeça, mas sabe exatamente qual estante ir buscar e volta com a página certa marcada. A analogia quebra quando você lembra que o estagiário sabe que não sabe. O modelo, quando o índice não devolve nada útil, pode ainda assim tentar gerar uma resposta que pareça fundamentada. Isso é o famoso risco de citação inventada, que já derrubou advogados em corte antes.
O trabalho da OpenAI com o Free Law Project, a organização por trás do CourtListener, traz o acervo de case law dessa iniciativa para dentro da plataforma.
Camada 3: plugins e conectores
A parte mais interessante do anúncio é que a OpenAI está construindo o Astra for Law em torno das ferramentas jurídicas existentes em vez de esperar que os escritórios movam tudo para dentro do ChatGPT. Foram anunciados 26 plugins construídos por parceiros, incluindo integrações com iManage, Intapp, DeepJudge, Relativity e Clio. A Thomson Reuters está trazendo contexto de matérias do HighQ para dentro do ChatGPT e também está mostrando um preview de um conector CoCounsel Legal. Além disso, nove plugins comunitários da LegalQuants, LECG e Skills.law incluem 47 skills jurídicas customizáveis.
Em termos de mecanismo, plugin aqui significa que o modelo tem uma ferramenta declarada (nome, descrição, esquema de parâmetros) que ele pode chamar durante a conversa. Quando o modelo decide chamar, a plataforma executa a chamada contra o sistema do parceiro (iManage para documentos, Relativity para ediscovery, Clio para prática) e devolve o resultado no contexto. É o mesmo padrão de tool use que a OpenAI já usa em outros produtos, agora com um catálogo pré-aprovado voltado para o setor.
Como aparece para o desenvolvedor
A OpenAI diz que o sistema aparece como “GPT-6 Astra Law” no seletor de modelo e como gpt-6-astra-law através da API. O acesso via API está sendo oferecido inicialmente a clientes como Harvey e Legora, e o programa Trusted Access mira escritórios do Am Law 200, dando acesso especializado através do ChatGPT e do Codex.
O que isso significa na prática
Um fluxo típico, reconstruído a partir do que o anúncio descreve:
- Um advogado abre o ChatGPT Enterprise e seleciona GPT-6 Astra Law.
- Ativa o plugin do iManage, do Relativity e o índice de busca jurídica.
- Faz uma pergunta como “encontre precedentes do Segundo Circuito sobre X nos últimos cinco anos e compare com os documentos da matéria Y no iManage”.
- O modelo decide chamar o índice de busca jurídica, recebe passagens relevantes, decide chamar o plugin do iManage, recebe os documentos da matéria, e sintetiza uma resposta com citações.
Tudo isso é orquestração de ferramentas em cima de um modelo generalista. O ganho declarado está em três lugares: o índice específico, os defaults ajustados para o domínio e os conectores prontos. Não há afirmação, no material que vi, de que o modelo tenha sido re-treinado ou fine-tunado em corpus jurídico. A palavra usada é configured. Isso importa.
Para dar uma referência de benchmark: a OpenAI testou o Astra for Law em 200 perguntas de pesquisa jurídica dos EUA do conjunto privado de validação do Legal Research Bench da Vals AI. Segundo a cobertura, o Astra for Law superou significativamente modelos padrão, incluindo o próprio GPT-6 Astra, em recuperação factual e correção. É um número que vem da própria OpenAI, então cabe cautela até haver avaliação independente.
Onde quebra
Alguns limites são explícitos no material, outros são consequência óbvia da arquitetura descrita.
- Escopo geográfico. O índice cobre direito dos Estados Unidos. Case law, estatutos e regulamentos brasileiros não estão nesse corpus. Um escritório no Brasil que queira o mesmo comportamento vai precisar montar o próprio pipeline de retrieval em cima de um modelo generalista, o que é possível hoje via API, mas não vem pronto.
- Acesso restrito. O Astra for Law está disponível nos EUA para escritórios selecionados através do programa Trusted Access. Esses escritórios podem usar Zero Data Retention com a API, enquanto o uso do ChatGPT Enterprise é excluído de revisão humana por padrão. Ou seja, não é algo que qualquer advogado assina hoje.
- Alucinação continua sendo alucinação. RAG reduz, não elimina. Quando o índice devolve resultado ruim ou nada, o modelo pode gerar afirmação com aparência de fundamentada. Um índice de 230 milhões de URLs não garante que a passagem específica que você precisa está lá, nem que o modelo escolheu a certa.
- Dependência do plugin do parceiro. A qualidade do conector com iManage, Relativity, Clio, etc, depende do parceiro. Se a integração devolve metadado pobre ou trecho errado, o modelo trabalha com dados errados.
- Confidencialidade de conversa. Aqui uma nota da minha experiência: no StartAtende, meu agente de suporte no WhatsApp, uma coisa que aprendi rápido é que usar conversa de cliente como inteligência exige cuidado com o que pode ou não ser lido e guardado. Em contexto jurídico o ponto é ainda mais sensível: sigilo profissional, privilégio, obrigação de guarda. Zero Data Retention resolve parte, mas a política operacional dentro do escritório resolve o resto.
O que não dá para afirmar ainda
Algumas coisas ficam em aberto:
- Se o GPT-6 Astra foi fine-tunado em dados jurídicos ou se é o mesmo modelo base com prompt e ferramentas diferentes. As reportagens usam “configured” e “tailored”, que sugerem o segundo, mas não confirmam.
- Como exatamente o índice de busca ranqueia resultados: se é embedding puro, se combina com sinais de citação e autoridade, se pondera vigência de norma. Não achei detalhe técnico público.
- Latência real e custo por consulta. O anúncio não traz preço.
- Se o benchmark da Vals AI foi auditado por terceiros ou se o resultado citado veio inteiramente da OpenAI.
- Se e quando haverá suporte a jurisdições fora dos EUA.
Como testar isso você mesmo
Se você não está no Trusted Access (que é a maioria de nós), dá para reproduzir a mecânica em escala menor e entender na prática o que está por baixo:
- Pegue a API padrão da OpenAI e um modelo com uso de ferramentas.
- Monte um índice pequeno usando embeddings sobre um corpus jurídico público. Para o Brasil, a base do LexML ou do STF já dá bastante material.
- Declare uma tool
buscar_jurisprudencia(query, limite)que faz busca vetorial nesse índice e devolve trechos com metadado. - Escreva um system prompt que force o modelo a citar o trecho recuperado e a dizer “não encontrei autoridade” quando o retorno vier fraco.
- Faça vinte perguntas reais. Metade sobre temas com jurisprudência abundante, metade sobre coisa obscura. Meça quantas vezes ele inventa citação.
Esse exercício ensina duas coisas que nenhum anúncio ensina: o quanto o resultado depende da qualidade do índice, e o quanto o modelo, mesmo instruído, ainda escorrega quando o retrieval falha. É a mesma equação que o Astra for Law está resolvendo com muito mais dinheiro e dados, mas a mecânica é a mesma.