A OpenAI publicou em setembro de 2026 um estudo de caso descrevendo como a Fyxer, uma startup de Londres, construiu um assistente executivo de IA que organiza inboxes e escreve rascunhos de email na voz do usuário. O artigo detalha decisões concretas de arquitetura: fine-tuning supervisionado, LoRA, Direct Preference Optimization, e uma malha de modelos pequenos em vez de um único LLM gigante fazendo tudo.
O fato
A publicação está em openai.com/index/fyxer. Segundo o material, a Fyxer usa fine-tuning supervisionado e Low-Rank Adaptation (LoRA) em seu sistema para criar variantes de modelo específicas por tarefa, controlando o custo de treinamento. A base de dados de treinamento vem de uma agência humana que os fundadores operaram por anos antes de lançar o produto de IA: mais de 500.000 horas de fluxos de trabalho executivos anotados, capturando como assistentes reais gerenciam comunicação profissional.
Números reportados pela empresa e resumidos em cobertura secundária: 53% dos rascunhos são aceitos como escritos, 90% de retenção em 90 dias, e crescimento de receita de US$ 1M para US$ 32M ARR em 2025. Vou tratar esses números como reportados pela empresa, não como verificáveis independentemente.
Como funciona
A escolha central: quebrar o problema em muitos modelos pequenos
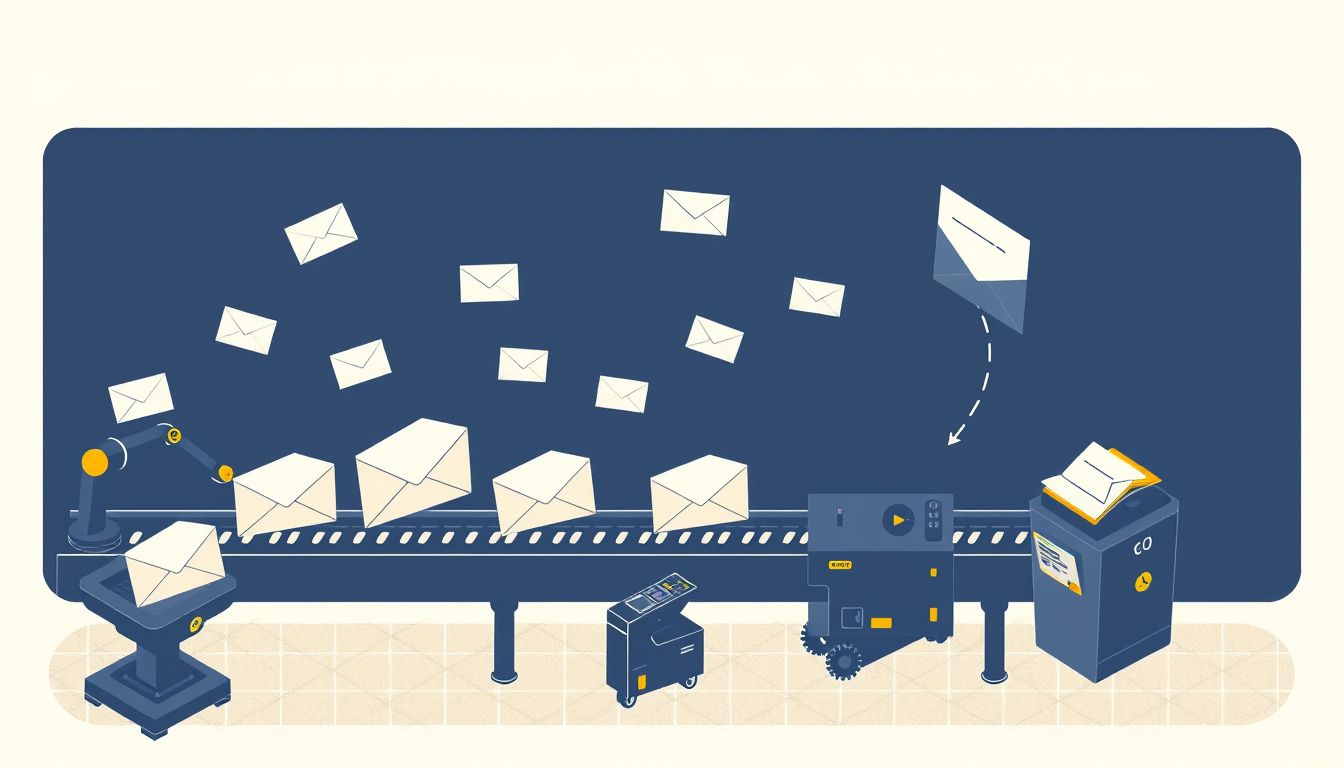
A decisão de arquitetura mais interessante do sistema é não usar um LLM gigante para gerar o email inteiro. Segundo cobertura do lançamento, o sistema divide as tarefas entre 30 a 50 modelos especializados que lidam com classificação, previsão de intenção, recuperação de memória e geração de rascunho, em vez de um único modelo grande de geração de texto.
Pense num restaurante durante o rush do almoço. Você pode colocar um único chef muito bom fazendo tudo, do risoto ao sushi, do pedido à sobremesa. Ele consegue, mas é lento, comete erros em pratos que não domina, e você paga caro pelo tempo dele. Ou você pode montar uma linha: alguém só recebe o pedido, alguém só corta legume, alguém só sela proteína, alguém só monta o prato. Cada estação é mais barata, mais rápida e melhor na coisa específica que faz. O prato final é montado no fim.
A analogia quebra num ponto importante: no restaurante os pratos são padronizados. No email, o “prato final” muda a cada thread. Então a orquestração precisa decidir a cada nova mensagem qual conjunto de estações ativar e em que ordem. Mas a mecânica de base é a mesma: cada modelo pequeno faz uma decisão bem definida (isto é urgente? isto precisa de resposta? qual thread anterior importa? qual tom usar?) e o rascunho final é a composição dessas decisões.
Do lado prático da inferência, um modelo pequeno especializado costuma ser mais rápido, mais barato e mais previsível numa tarefa estreita do que um modelo grande generalista fazendo a mesma coisa via prompt. O trade-off é ter que treinar e manter cada um deles.
Como o fine-tuning é feito sem estourar o custo
Aqui entra o LoRA. Fine-tuning tradicional atualiza todos os pesos do modelo, o que exige muita GPU e muito tempo. LoRA (Low-Rank Adaptation) faz uma coisa diferente: congela os pesos originais do modelo e treina apenas matrizes pequenas “por cima”, que representam a diferença entre o comportamento base e o comportamento desejado. Você fica com um adaptador de poucos MB em vez de um modelo inteiro de dezenas de GB. Para servir, o adaptador é aplicado sobre o modelo base em tempo de inferência.
Isso explica por que a Fyxer consegue manter dezenas de variantes especializadas: cada uma é um adaptador barato de treinar e armazenar, não um modelo inteiro replicado.
Sobre a infraestrutura de treinamento em si, o material da OpenAI diz que no início do produto a equipe usou a plataforma de fine-tuning da OpenAI para tarefas que exigiam alta acurácia, e mais recentemente trabalhou com o time de fine-tuning gerenciado da OpenAI para colocar um novo checkpoint em produção. O artigo não detalha quais modelos base específicos, o que fica na zona do que não dá para afirmar.
Como o feedback do usuário vira treino
Este é o loop que faz o sistema melhorar com uso. Segundo cobertura do lançamento, a Fyxer usa fine-tuning supervisionado, LoRA e Direct Preference Optimization derivada das edições do usuário para melhorar continuamente os rascunhos, validando mudanças através de testes A/B.
DPO (Direct Preference Optimization) é uma técnica que treina o modelo a preferir uma resposta sobre outra a partir de pares (versão A, versão B, humano preferiu B). No caso da Fyxer, o par natural aparece sozinho: a Fyxer gera o rascunho, o usuário edita antes de enviar, e agora você tem dois textos, o gerado e o enviado. O enviado é o “escolhido”, o gerado é o “rejeitado”. Cada edição do usuário vira um sinal de treino sem que ninguém precise rotular nada.
O detalhe importante é o A/B test como portão. Não é porque um novo checkpoint parece melhor nas métricas offline que ele vai para produção. Ele é servido para um subgrupo, comparado contra o modelo atual em métricas reais (taxa de aceitação, quantidade de edição), e só sobe se ganhar. Isso protege contra o caso comum onde o modelo “melhora” numa métrica sintética e piora na experiência real.
O que o modelo lê antes de escrever
A Fyxer não gera o rascunho a partir só da última mensagem. A documentação de suporte descreve que a Fyxer gera um rascunho quando um thread é classificado como “To Respond” e a configuração de rascunho está ligada. Ou seja, há primeiro um classificador decidindo se aquele email merece rascunho, depois um gerador. E o gerador recebe contexto: o sistema é informado por 500 mil horas de experiência de EA e se apoia no seu próprio histórico de email conforme cresce, puxando contexto de threads e reuniões em vez de apenas a mensagem à frente.
Em termos de fluxo, dá para desenhar assim, passo a passo:
- Email novo chega no Gmail ou Outlook via API.
- Um classificador decide categoria (marketing, notification, precisa resposta, FYI).
- Se “precisa resposta”, outro modelo decide o tipo de resposta esperada (agendamento, confirmação, recusa, follow-up de projeto).
- Um componente de recuperação puxa contexto relevante: threads anteriores com o mesmo remetente, notas de reuniões relacionadas, preferências do usuário.
- O gerador de rascunho, ajustado com LoRA para o estilo do usuário, escreve o texto.
- O rascunho vai para a pasta Drafts. Nunca é enviado automaticamente, o usuário mantém o controle e pode editar antes de enviar.
- Se o usuário editar antes de enviar, a diferença vira sinal para o próximo ciclo de treino.
O que isso significa na prática
A lição de arquitetura mais útil aqui, e que se aplica muito além de email, é a de decompor uma tarefa aparentemente monolítica (“escrever o email certo”) numa sequência de decisões pequenas onde cada uma pode ser medida, treinada e substituída de forma isolada.
Numa plataforma de conteúdo gerado por LLM em escala de catálogo, cheguei a uma conclusão parecida por outro caminho: o que estabiliza a qualidade não é escolher o modelo maior, é ancorar a geração em dado estruturado real e rodar validação antes de publicar. Um modelo generalista pedindo tudo em um prompt gigante alucina em cascata. Um pipeline que primeiro decide o que buscar, depois busca, depois valida, depois gera, quebra em pontos onde você consegue medir e consertar.
Uma versão mínima do padrão da Fyxer, aplicada a qualquer domínio de resposta assistida, se parece com isto:
entrada = mensagem_nova

# 1. classificar
categoria = classificador_leve(entrada)
if categoria != "precisa_resposta":
 arquivar(entrada, categoria)
 return

# 2. entender intenção
intent = modelo_intent(entrada)

# 3. buscar contexto
contexto = memoria.buscar(
 remetente=entrada.remetente,
 topico=intent.topico,
 limite=5
)

# 4. gerar com adaptador do usuario
rascunho = gerador_base.com_lora(usuario.adaptador_id).gerar(
 mensagem=entrada,
 intent=intent,
 contexto=contexto,
 estilo=usuario.perfil_de_escrita
)

# 5. entregar como rascunho, nunca enviar
salvar_rascunho(rascunho)

# 6. no envio, comparar texto final com rascunho
# a diferenca vira par (rejeitado, escolhido) para DPO futuro
Nenhum passo aqui é novo em separado. A escolha da Fyxer foi tratar cada um como um modelo pequeno especializado em vez de um prompt dentro de um modelo grande.
Onde quebra
Manter 30 a 50 modelos especializados tem um custo operacional real: cada um precisa de dados, avaliação, deploy, versionamento e monitoramento em produção. Uma equipe pequena tentando reproduzir este padrão sem os 500 mil horas de dados anotados vai encontrar rapidamente o problema inverso do que motivou a decisão: em vez de custo alto de inferência num modelo grande, você paga custo alto de manutenção em muitos modelos pequenos que ninguém sabe se ainda estão calibrados.
O feedback loop via edições do usuário também tem viés inerente. Um usuário que edita muito pode ser exigente com estilo, ou pode ser que o modelo esteja consistentemente errando em um segmento específico de emails, e você não distingue os dois só olhando a métrica agregada. Aqui o A/B test ajuda, mas não resolve o caso do usuário que edita menos por cansaço, aceita rascunhos ruins e ensina o modelo que “ruim” é aceitável.
Sobre a captura da voz do usuário: o material da própria Fyxer é honesto em dizer que a qualidade do rascunho melhora conforme a Fyxer vê mais dos seus emails enviados. Traduzindo: nas primeiras semanas, os rascunhos são fracos. Isso é limitação estrutural de qualquer sistema baseado em fine-tuning por usuário, não bug.
Existe também o limite do domínio. A própria Fyxer publicou análise reconhecendo que negociação e agendamento complexos ainda não são bem atendidos por IA: itinerários internacionais multi-trecho, gerenciar preferências de programas de fidelidade, lidar com mudanças de última hora quando uma conexão cai, manter preferências de assento e requisitos alimentares consistentes entre sistemas, tudo isso ainda é largamente manual, e apesar das melhorias, EAs gerenciando viagens complexas para executivos exigentes não deveriam repassar essas tarefas esperando confiabilidade ainda.
O que não dá para afirmar ainda
O artigo original da OpenAI, na parte que consegui capturar, descreve as técnicas em nível conceitual mas não especifica: qual modelo base é usado para o gerador, como exatamente os 30 a 50 modelos são orquestrados, se há um roteador aprendido ou regras determinísticas, com que frequência os adaptadores LoRA por usuário são retreinados, e como a memória de longo prazo é indexada. As citações sobre “30 a 50 modelos” e “DPO derivada de edições” vêm de cobertura secundária (daily.dev) que resume o artigo, e eu não confirmei palavra por palavra contra a fonte primária.
As métricas de negócio (53% de aceitação, 90% de retenção, ARR) são reportadas pela empresa. Não são verificáveis por terceiros a partir do material disponível. Trate-as como marketing bem-fundamentado, não como benchmark.
Também não vi menção clara a se o DPO é rodado por usuário (adaptador de preferência individual) ou agregado entre usuários. Faz diferença enorme para custo e para privacidade, e o material não esclarece.
Como testar isso você mesmo
Se você quer sentir o mecanismo sem reconstruir a Fyxer, um caminho pequeno é este:
- Pegue uma pasta com 200 dos seus emails enviados.
- Escreva um classificador simples (pode ser via prompt em um modelo pequeno) que rotule cada thread recebido em três categorias: precisa resposta, informativo, ignorar.
- Para os que precisam resposta, faça um gerador (também via prompt) que produza rascunho usando os últimos 3 emails que você enviou para o mesmo destinatário como few-shot de estilo.
- Compare, à mão, seus 20 próximos envios reais com o rascunho gerado. Anote onde o modelo errou: tom, estrutura, tamanho, sign-off.
- Só depois disso, se ainda fizer sentido, considere fine-tuning ou LoRA. Você vai descobrir que quase todo o ganho inicial vem da etapa 2 (o classificador) e da etapa 3 (o contexto certo no prompt), não do modelo em si.
Esse experimento leva um fim de semana e ensina, na prática, por que a Fyxer decidiu quebrar o problema em vez de jogar tudo em um único modelo grande. O aprendizado real fica quando você mede quanto tempo cada etapa consome, quanto ela custa em tokens, e onde o erro se acumula.