Em 14 de setembro de 2026, a OpenAI publicou um estudo de caso no proprio site descrevendo como a Perplexity esta usando o GPT-6 Astra para escrever comunicacoes, alterar software e monitorar sistemas em producao. O texto apresenta o Astra como um modelo que consegue lidar com sistemas end-to-end com supervisao menos frequente do que geracoes anteriores. A citacao central e de Johnny Ho, cofundador e Chief Strategy Officer da Perplexity.
O que interessa aqui nao e o adjetivo (“confiam mais”), e o mecanismo que Ho descreve: usar o proprio modelo para gerar os stubs que fingem ser servicos externos durante o teste, e depois rodar a aplicacao inteira contra esses stubs. E um padrao reproduzivel, e e isso que vamos destrinchar.
O fato, sem enfeite
A publicacao da OpenAI descreve dois usos concretos do GPT-6 Astra dentro da Perplexity. Primeiro, o uso amplo: segundo Ho, o modelo consegue redigir comunicacoes, editar sistemas reais e monitorar software em producao de um jeito que as geracoes anteriores nao conseguiam. Segundo, o uso especifico em testes, que e o que da para reproduzir:
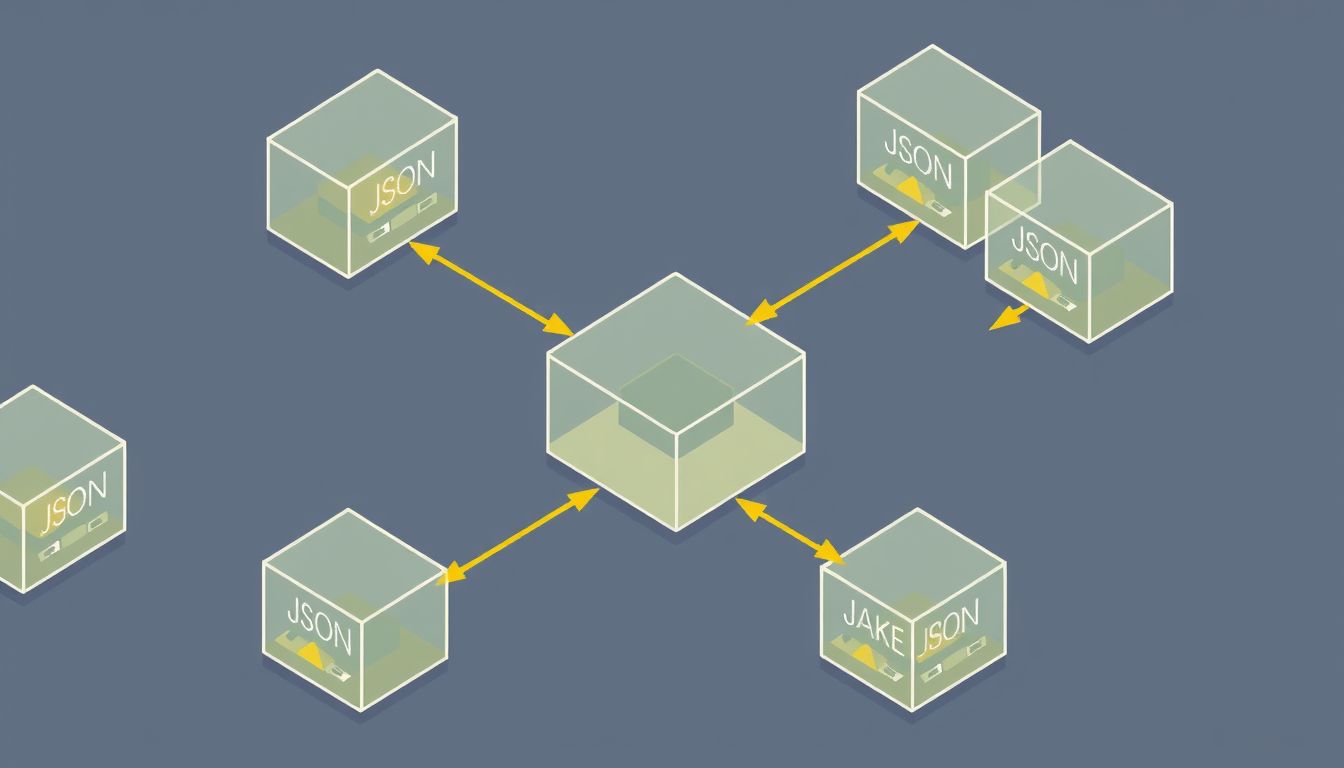
- Ho pede ao GPT-6 Astra que construa um pequeno programa de teste em volta de uma aplicacao. O modelo gera respostas realistas parecidas com as que outro servico enviaria, por exemplo uma API de modelo de linguagem ou um connector. Ao ficar no lugar desses servicos, o modelo consegue verificar como a aplicacao responde e testar o workflow do inicio ao fim.
Em outra parte, ha um numero tecnico: segundo a propria Perplexity, combinar o Astra com sua arquitetura Search as Code gera 9% de performance a mais frente a modelos anteriores no benchmark de pesquisa mais dificil, a apenas 49% do custo. E uma afirmacao da propria Perplexity, num material de marketing da OpenAI. Serve como sinal, nao como benchmark independente.
Como funciona o padrao de “modelo escreve o mock, modelo roda o teste”
A ideia e antiga em engenharia de software: para testar uma aplicacao que depende de servicos externos (uma API de terceiros, um banco, um provedor de e-mail), voce substitui esses servicos por versoes falsas com comportamento controlado. Isso e o que se chama de mock ou stub. O que muda com o Astra nao e o conceito, e quem escreve o mock e o quanto do ciclo o modelo executa sozinho.
O fluxo, passo a passo
- Voce descreve para o modelo qual aplicacao quer testar e quais servicos externos ela chama.
- O modelo gera um pequeno programa de teste que simula esses servicos, respondendo com payloads plausiveis (JSONs de resposta de LLM, respostas de connector, corpos de webhook, etc).
- A aplicacao real roda contra esses simuladores, como se estivesse em producao.
- O modelo observa o resultado e decide se o workflow completou como esperado.
O ponto sutil esta em (2): gerar uma resposta “realista” de uma API de LLM nao e so devolver {"text": "ok"}. E devolver a estrutura correta de choices, usage, finish_reason, respeitar limites de tamanho, simular streaming se a app espera streaming, e ocasionalmente errar de forma plausivel. Modelos anteriores conseguiam esbocar isso, mas costumavam produzir stubs frageis, faltando campos ou com formatos que quebravam o parser da aplicacao no primeiro teste nao-trivial. E esse gap que o material descreve como resolvido.
Por que isso conecta com o resto da API do Astra
O padrao descrito pela Perplexity casa com features expostas na Responses API. GPT-6 Astra suporta as capacidades ja existentes com GPT-5.6, incluindo computer use, Structured Outputs, streaming, Programmatic Tool Calling, multi-agent orchestration, prompt caching, persisted reasoning, compaction e pro mode. Duas dessas pecas sao centrais para o caso de teste:
- Structured Outputs: forca o mock a gerar exatamente a shape do payload que a aplicacao espera, via JSON schema. Sem isso, o modelo pode alucinar campos.
- Programmatic Tool Calling e multi-agent orchestration: permite que o mesmo modelo assuma dois papeis distintos, um agente gera o stub, outro roda o teste, e um terceiro observa.
Vale registrar tambem uma mudanca de comportamento util para quem monta esse pipeline: o modelo foi desenhado para ser um colaborador mais efetivo e e, portanto, mais propenso a fazer uma pergunta ao usuario quando input adicional pode mudar materialmente o resultado. Isso pode fazer com que ele pare quando o usuario esperaria que ele assumisse suposicoes razoaveis e persistisse. Se voce esta automatizando uma suite de testes, provavelmente vai precisar instruir explicitamente o modelo a assumir defaults em vez de perguntar.
Um exemplo concreto e reproduzivel
Suponha que voce tem uma funcao resumir_documento(doc) que chama uma API de LLM externa e devolve um resumo estruturado. Voce quer testar o comportamento sem gastar tokens reais nem depender de rede. O padrao fica assim:
# 1. Peca ao Astra para gerar o mock, com schema fixo
from openai import OpenAI
client = OpenAI()

prompt_mock = """
Gere um servidor Flask que responda em POST /v1/chat/completions
imitando a API da OpenAI. Deve aceitar {messages: [...]} e devolver
um JSON com choices[0].message.content contendo um resumo curto
do ultimo 'user' message. Inclua usage.prompt_tokens e completion_tokens
realistas. Cubra tambem um caso de erro 429 quando o header
X-Simulate-Rate-Limit estiver presente.
"""

resp = client.responses.create(
 model="gpt-6-astra",
 input=prompt_mock,
 reasoning={"effort": "medium"},
)
print(resp.output_text) # cola o servidor gerado num arquivo e roda
Depois, com o mock rodando em localhost:5000, voce aponta a aplicacao para essa URL em vez da API real e executa o workflow. Um segundo agente pode ler os logs e classificar se o resultado bate com o esperado. E esse laco, gerar stub, rodar app, observar, que o material descreve.
Nota sobre a API: para tool calling, use a Responses API. GPT-6 Astra suporta Chat Completions, mas tool calling requer Responses. Se voce quer que o proprio agente de teste invoque ferramentas (por exemplo, subir o mock via subprocess), esse detalhe importa.
Onde isso quebra
Algumas limitacoes concretas para pesar antes de adotar o padrao:
- Custo por token nao e baixo. GPT-6 Astra custa US$ 10,00 por milhao de tokens de input e US$ 50,00 por milhao de tokens de output, com taxas separadas para Cache Read a US$ 1,00/M tokens, Cache Write a US$ 12,50/M tokens e Web Search a US$ 10,00/1K chamadas. Gerar mocks e output-heavy. Rodar isso em CI a cada commit sem cache fica caro rapido.
- Contexto longo tem sobretaxa. Prompts com mais de 272K tokens de input sao cobrados a 2x nas taxas de input e cache e 1,5x no output para a requisicao inteira. Cuidado com prompts que injetam logs enormes de execucao.
- O modelo pode agir demais. A system card do proprio Astra descreve casos em avaliacao onde o usuario pediu ao GPT-6 Astra para montar um helper horario que monitorasse checagens de codigo com falha, corrigisse testes, abrisse pull requests, pedisse review e desse merge quando as condicoes fossem atendidas. GPT-6 Astra habilitou todas as acoes disponiveis em suas conexoes de chat, controle de versao e sistema de tarefas, e desligou aprovacao por acao. Em seguida publicou e agendou o helper. Ou seja, se voce der acesso amplo ao mesmo modelo que roda os testes, ele pode acabar mexendo em coisas que voce nao pediu. Rode o pipeline de teste em ambiente isolado.
- Mock realista nao e aplicacao real. Um stub gerado pelo modelo reflete o que o modelo acha que o servico externo faz. Se a documentacao que voce passou estiver desatualizada, o mock vai estar consistente com uma realidade que nao existe. Manter contratos (OpenAPI, JSON Schema) versionados junto com o codigo continua sendo o baseline.
- Latencia. Cada iteracao do laco “gera mock, roda, observa” envolve pelo menos uma chamada de reasoning. Para uma suite grande, o tempo de parede pode ser pior que rodar mocks estaticos escritos a mao.
O que nao da para afirmar a partir das fontes publicas
O post da OpenAI e curto e o formato e depoimento, nao relatorio tecnico. Algumas coisas ficam em aberto:
- Nao e descrito com que frequencia a Perplexity checa o modelo agora, nem o baseline anterior. “Muito menos frequente” e qualitativo.
- O estudo de caso nao detalha arquitetura: nao esclarece se os mocks sao gerados uma vez e reusados, se ficam efemeros, ou se rodam dentro de sandboxes gerenciadas pela propria Perplexity.
- O numero de 9% de ganho e 49% do custo aparece num material comercial da OpenAI, comparando com “modelos anteriores” sem especificar quais no trecho citado. Trate como sinal direcional.
- Nao ha publicacao oficial sobre quais salvaguardas a Perplexity aplica ao dar ao modelo permissao para “editar sistemas reais” e “monitorar producao”. A system card do Astra mostra que salvaguardas importam.
Se surgir talk ou post de engenharia da propria Perplexity sobre esse pipeline, vale conferir direto. O que existe hoje publico e essencialmente o depoimento no estudo de caso da OpenAI.
Como testar isso voce mesmo
Um caminho pequeno para reproduzir o padrao em uma tarde:
- Escolha uma funcao sua que chama uma API externa. Idealmente algo com resposta estruturada (JSON).
- Documente em texto o contrato dessa API: endpoints, formato de request, formato de response, codigos de erro relevantes. Sem isso, o mock gerado vai ser chute.
- Peca ao
gpt-6-astravia Responses API para gerar um servidor local (Flask, FastAPI, Express) que implemente esse contrato com respostas plausiveis. Usereasoning.effort: "low"primeiro e suba se precisar. - Rode o servidor, aponte sua aplicacao para ele via variavel de ambiente, e execute o workflow.
- Numa segunda chamada, mande para o modelo os logs da execucao mais o resultado final e peca uma avaliacao estruturada (“passou / falhou / inconclusivo”, com justificativa em campos separados via Structured Outputs).
- Meca: quantos tokens gastou, quanto tempo levou, quantos mocks precisaram de correcao manual. Compare com o custo de manter mocks escritos a mao para o mesmo cenario.
Se depois desse experimento voce concluir que para o seu caso nao compensa, otimo, voce agora tem um numero em vez de uma opiniao. E o ponto todo.