O fato
Em 3 de setembro de 2026, a Hugging Face publicou o anúncio do funes, escrito por David Corvoysier (dacorvo), engenheiro do time da empresa. O texto descreve uma ferramenta de linha de comando que indexa as sessões já produzidas por agentes de codificação (Claude Code, Codex, pi e Hermes) e transforma esse histórico em memória pesquisável, que pode ficar só na sua máquina ou ser publicada como um dataset da Hugging Face que você mesmo controla.
O projeto é open source, está hospedado em github.com/huggingface/funes e, segundo o repositório, é implementado majoritariamente em Rust sob licença Apache 2.0. Não é um serviço novo de IA: é uma camada de indexação e busca sobre algo que os agentes já geram sozinhos, os logs de sessão.
Como funciona
O problema que o funes ataca: traces não são memória, são arquivo
O ponto de partida do anúncio é outro artigo da própria Hugging Face, “Software Forgets: Agent Traces Are the Memory”, publicado meses antes. Aquele texto argumenta que o contexto que explicaria por que um código é do jeito que é hoje acontece, cada vez mais, em conversas privadas entre um engenheiro e um agente, e que as ferramentas tradicionais de preservar contexto (comentários, docs, wikis, logs de decisão) dependem de alguém manter isso atualizado, o que é trabalho de manutenção que costuma perder para trabalho de feature.
O anúncio do funes descreve os agentes assim: “como eles buscam num código, tentam abordagens, batem em erros, leem documentação e mudam de direção, eles deixam para trás um registro denso não só do que mudou, mas do porquê”. O diagnóstico está correto, mas o próprio autor é honesto sobre o limite dele: “os traces são só memória em potencial. Os logs de sessão de um agente ainda são apenas um arquivo. Você não consegue dar grep para achar por que a equipe abandonou o parser de streaming em dez mil turnos”. Para um agente usar esse histórico enquanto trabalha, ele precisa de indexação, recuperação, ranqueamento e proveniência exata, e é isso que o funes se propõe a fazer.
O pipeline de indexação, passo a passo
O funes é distribuído como um binário único. A instalação é feita por um script que baixa o executável correto para a plataforma:
curl -fsSL https://huggingface.co/buckets/huggingface/funes/resolve/install.sh | shDepois, um único comando conecta a ferramenta a um agente já instalado:
funes add claude
# ou: codex, pi, hermes
Esse comando de add constrói o primeiro índice, dá ao agente as ferramentas recall e get, e instala a automação que indexa cada turno concluído. A indexação é incremental: novas execuções adicionam novos turnos em vez de reembedar todo o histórico de novo, e o conteúdo mais antigo e profundo pode ser preenchido em etapas limitadas (o texto original usa a palavra backfill para esse preenchimento posterior).
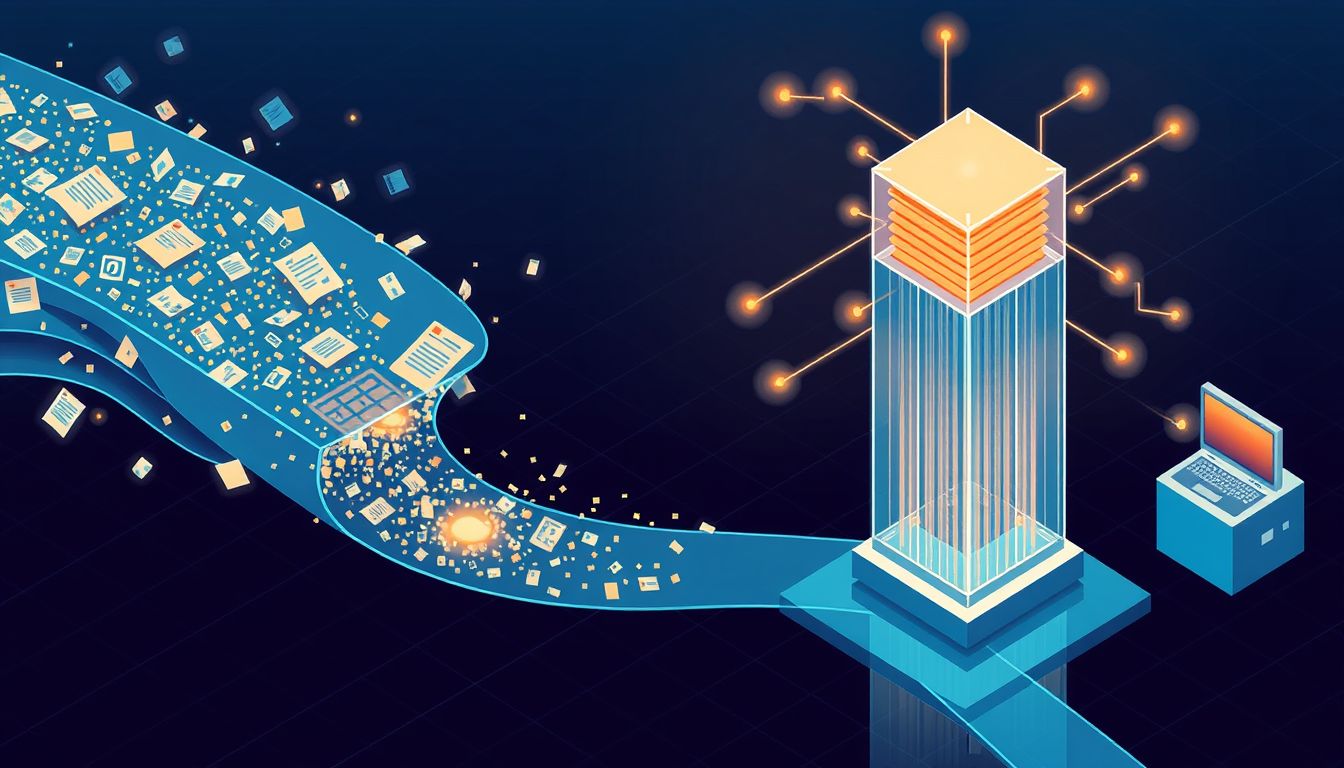
Por baixo, um pipeline determinístico analisa cada trace suportado no mesmo formato de turno e bloco, faz o chunking, embeda com um modelo local fixo (pinned) e escreve num dataset Lance local. Quando uma consulta chega, o mecanismo de busca combina duas técnicas: busca vetorial (por similaridade semântica) e BM25 (busca por termos, o mesmo algoritmo clássico usado em motores de busca de texto). Os dois ranqueamentos são fundidos, depois um cross-encoder (um modelo que compara par a par a pergunta com cada candidato) reordena os resultados, uma reponderação por recência favorece o que é mais recente, e por fim o sistema anexa os chunks vizinhos para dar contexto.
O formato de armazenamento escolhido, o Lance, não é uma invenção do projeto. É um formato colunar aberto, nativo do ecossistema Arrow, pensado para acesso aleatório rápido sem perder desempenho de varredura. A documentação da própria Hugging Face sobre o formato explica que a indexação é cidadã de primeira classe, nativa do próprio formato: o Lance vem com índices vetoriais e de busca por texto completo rápidos, em disco e escaláveis, que ficam ao lado do dataset no Hub. Isso é relevante para o funes porque permite escrita incremental barata: é possível adicionar colunas derivadas, como embeddings, depois, sem reescrever a tabela inteira, e apenas dados novos são escritos, enquanto dados existentes ficam intocados.
Memória local versus memória compartilhada
Por padrão, tudo roda na sua máquina. Segundo o anúncio, nenhuma conta ou repositório do Hub é necessário; um modelo hospedado não processa suas sessões para indexação, o embedding e o reranking rodam na sua máquina, e quem faz o raciocínio é o seu agente de código. Isso importa porque separa duas coisas que costumam vir juntas em ferramentas de IA: usar um modelo para processar dados sensíveis e depender de um serviço externo para isso.
Quando você quer que a memória atravesse máquinas, o comando muda:
funes add codex acme/funes-memoryIsso vincula (bind) a memória local a um dataset no Hugging Face Hub. O bind publica a memória atual ali, e o funes mantém isso atualizado, indexando localmente a cada turno e publicando nas fronteiras de sessão. Antes de qualquer coisa subir para o Hub, há uma etapa de redação de credenciais durante a indexação, e a publicação varre cada chunk de novo, retendo o que ainda parecer um segredo; o comportamento exato desse scanner está documentado no arquivo SECURITY.md do repositório, que o próprio anúncio cita como referência para entender o que a checagem cobre e o que não cobre.
O dataset publicado é, por padrão, privado, e pertence à sua conta, não a um serviço de memória terceirizado. Isso é uma escolha de arquitetura explícita: a memória é um dataset da Hugging Face; publicada no Hub, um colega, outra das suas máquinas, ou qualquer pessoa, se você tornar público, consegue recuperar dela com uma flag.
O que isso significa na prática
Depois do add, o fluxo de trabalho normal já basta. Quando uma tarefa toca uma decisão, motivo ou descoberta antiga, o agente pode buscar na própria memória sem que você precise colar contexto de outra sessão. Cada resultado retornado por recall vem com proveniência: agente de origem, timestamp, sessão e turno, e um comando get que abre o turno completo com o contexto ao redor.
Para fazer uma pergunta pontual sem instalar nada, existe o comando ask, que funciona como um modo de leitura de uma pergunta só:
funes ask claude "o que decidimos sobre o parser de streaming"Ou apontando para uma memória compartilhada publicada por outra pessoa. A própria Hugging Face publicou o histórico de desenvolvimento do funes como um dataset público chamado huggingface/funes-memory, disponível para qualquer pessoa consultar:
funes ask claude "por que o funes e append-only" --memory huggingface/funes-memoryO comando recupera as sessões relevantes, entrega para um agente de código emprestado, e devolve uma resposta fundamentada que nomeia as sessões de onde ela veio, sem instalar nada. Se as passagens recuperadas não sustentam uma resposta, o agente diz isso em vez de inventar; é uma diferença importante frente a ferramentas de RAG que preenchem lacunas com alucinação.
O anúncio também traz um dado de custo comparando três formas de sobreviver a uma sessão longa que estoura o contexto: deixar o agente compactar (o comportamento padrão da maioria dos agentes), escrever um handoff manual, e usar recall. No benchmark publicado pela própria equipe, com duas tarefas cuja resposta não pode ser reconstruída sem o conhecimento prévio da sessão, a compactação foi o único dos três métodos cujo resultado se dividiu: chegou numa tarefa e nunca chegou na outra, porque o resumo tinha achatado descobertas que importavam. Já o recall foi o mais barato dos três nas duas tarefas, 8 vezes mais barato que um handoff escrito numa delas e 4 vezes na outra.
Onde quebra
Vale ser específico sobre os limites, porque o próprio material já sinaliza vários.
- Cobertura de agentes limitada. O suporte hoje é para quatro agentes nomeados: Claude Code, Codex, pi e Hermes. Se o seu fluxo de trabalho usa outro agente ou uma automação interna, não há indicação de que o funes leia esse formato de trace sem trabalho de adaptação.
- Latência fria em memória remota. Quando o agente lê uma memória publicada no Hub, o funes precisa baixar o dataset para cache local antes de responder rápido; a primeira consulta paga esse custo, e só as consultas seguintes voltam à velocidade local.
- Redação de segredos é best effort, não garantia. O próprio projeto documenta em SECURITY.md o que o scanner de segredos cobre e o que não cobre, o que é uma forma honesta de dizer que a checagem automática não substitui revisão humana antes de publicar uma memória que pode ter tocado em credenciais.
- O benchmark de custo é pequeno e autopublicado. O comparativo entre compactação, handoff e recall usa duas tarefas desenhadas pela própria equipe do funes, não um conjunto independente e mais amplo. É um indício, não uma prova de generalização para qualquer tipo de sessão ou qualquer volume de contexto.
- Ferramenta muito nova. O repositório mostra atividade de commits recente e concentrada, o que é esperado para um lançamento de poucos dias, mas também significa que ainda não existe um histórico longo de uso em produção por terceiros para se apoiar.
O que não dá para afirmar ainda
O material da Hugging Face não testa, nem discute, o comportamento do funes em bases de código muito grandes, com milhares de sessões acumuladas ao longo de anos; a comparação de custo publicada usa duas tarefas específicas, e não sabemos se a vantagem de custo do recall sobre handoff e compactação se mantém em sessões muito mais longas ou em investigações que cruzam dezenas de repositórios. O texto também não detalha o desempenho do modelo de embedding local em códigos e conversas fora do inglês, nem como o reranking se comporta quando duas decisões contraditórias aparecem na mesma memória, uma tomada e depois revertida. Por fim, não há dados independentes, de fora da Hugging Face, validando as alegações de custo ou a qualidade do retrieval; até o momento, a fonte primária desses números é a própria equipe que construiu a ferramenta.
Como testar isso você mesmo
O caminho mais curto para experimentar é local, sem publicar nada no Hub:
# instala o binario
curl -fsSL https://huggingface.co/buckets/huggingface/funes/resolve/install.sh | sh

# conecta a um agente que voce ja usa
funes add claude

# depois de uma sessao de trabalho normal, pergunte a memoria
funes ask claude "por que mudamos de abordagem no modulo X"
Para ver o lado da memória compartilhada sem criar a sua, dá para consultar o dataset público que a própria Hugging Face publicou sobre o desenvolvimento do funes, sem instalar nada:
funes ask claude "por que o funes e append-only" --memory huggingface/funes-memoryVale prestar atenção em duas coisas ao testar: se o recall realmente cita a sessão de origem quando responde (a proveniência é o ponto central da proposta), e o que acontece quando você pergunta algo que a memória claramente não cobre, se o agente admite a lacuna ou tenta preencher com suposição.