O que a OpenAI anunciou
Em 3 de setembro de 2026 a OpenAI publicou um caso de uso da Legora, plataforma sueca de IA para profissionais jurídicos, mostrando o GPT-6 Astra em um fluxo de revisão financeira. A Legora usou o GPT-6 Astra para revisar 41 documentos em minutos, encontrar todos os quatro erros plantados, e melhorar o desempenho em quase 40% nesse fluxo de revisão financeira. A Legora é descrita como um sistema operacional agentic para trabalho jurídico e profissional, usado por mais de 100.000 profissionais em mais de 1.800 departamentos jurídicos internos e escritórios de advocacia em mais de 50 mercados.
O caso testado foi um fluxo específico chamado tie-out financeiro: conferir cada número nas contas em rascunho contra balancetes, um cronograma de consolidação, e as contas do ano anterior, até que cada item bata. É um trabalho manual, repetitivo, e crítico para quem assina o documento depois.
Como funciona o mecanismo por trás do resultado
O que é tie-out e por que ele é tedioso
Tie-out não é uma tarefa de redação nem de interpretação jurídica complexa. É conferência cruzada: cada valor que aparece em uma demonstração financeira precisa aparecer, consistente, em pelo menos mais um documento de suporte (balancete, cronograma, ano anterior). Segundo a própria Legora, o trabalho pode levar uma noite inteira, às vezes dias. Isso não é porque é difícil no sentido analítico, é porque é volumoso e a chance de erro humano por cansaço é alta.
O agente da Legora rodando sobre GPT-6 Astra
A Legora não construiu um modelo próprio para isso. Ela roteia o trabalho para modelos de terceiros dentro do que chama de agente. A Legora é agnóstica de modelo e roteia tarefas entre múltiplos modelos de linguagem, principalmente da OpenAI e da Anthropic, dependendo da carga de trabalho, e a diferenciação da empresa está na camada de workspace jurídico e não em um modelo proprietário. Isso importa porque o resultado anunciado não é “a Legora treinou um modelo melhor”, é “a Legora trocou o motor de raciocínio por baixo do capô e mediu o que mudou”.
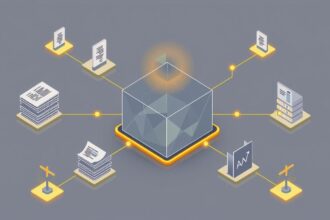
No caso do tie-out, o agente da Legora fez o trabalho em minutos: conferindo cada saldo contra seu cronograma de suporte, identificando quebras nos valores, e registrando cada verificação. Ou seja, o mecanismo descrito não é só “ler o documento e responder”, é rodar uma checagem item a item e deixar rastro de cada checagem, gerando um registro auditável em vez de uma resposta final única.
O que mudou tecnicamente no modelo
A documentação oficial da OpenAI para o GPT-6 Astra mostra a especificação técnica que explica por que essa tarefa passou a caber em uma única execução. O modelo tem uma janela de contexto de 1.050.000 tokens, saída máxima de 128.000 tokens, corte de conhecimento em 30 de abril de 2026, e suporte a tokens de raciocínio. Isso é o que permite ingerir 41 documentos financeiros de uma vez sem fragmentar em múltiplas chamadas separadas, o que historicamente é uma das maiores fontes de erro em revisão automatizada: quando você quebra o material em pedaços, o modelo perde a referência cruzada entre um valor no documento 3 e o mesmo valor no documento 27.
O preço também é parte do mecanismo, porque afeta viabilidade. O preço é de 10 dólares por milhão de tokens de entrada e 50 dólares por milhão de tokens de saída, valores que ficam na ponta mais cara entre os modelos de raciocínio comparáveis (mediana de 2 dólares de entrada e 10 dólares de saída). Preencher a janela inteira de contexto com documentos densos custa dinheiro real por chamada, o que muda o cálculo de quando vale rodar o agente em modo exaustivo.
Como a Legora mediu o ganho
O número de “quase 40%” não vem de uma prova isolada, vem de um benchmark interno que a própria Legora mantém. A Legora avaliou o GPT-6 Astra com o Legora Benchmark for Agentic Reasoning (BAR), que mede desempenho em tarefas jurídicas ponta a ponta extraídas de casos de uso reais. O BAR não é um teste sintético isolado: o harness da Legora equipa o modelo com as ferramentas, habilidades, fontes jurídicas e fluxos de trabalho necessários para o trabalho jurídico, e o ambiente do caso contém os documentos, playbooks, precedentes e templates que advogados usam.
É importante separar dois números que a fonte apresenta juntos e que fácil confundir: a Legora relata que o GPT-6 Astra melhorou o desempenho em quase 40% em relação ao modelo anterior nesse fluxo específico de demonstração financeira, e que, em todas as tarefas do BAR, a melhoria média foi de cerca de 3%. O ganho de 40% é específico da tarefa de tie-out. No conjunto geral de tarefas jurídicas que o BAR mede, o salto de um modelo para outro foi bem mais modesto.
Sobre os erros plantados: o GPT-6 Astra encontrou os quatro erros que a Legora havia plantado nas contas, incluindo uma lacuna de 500 mil libras escondida na nota de receita, conferiu cada saldo contra seu cronograma de suporte e registrou cada checagem, e manteve todas as checagens que o modelo anterior acertava, além de completar cerca de 50 checagens a mais.
O que isso significa na prática
Do ponto de vista de quem quer entender o padrão de uso, o fluxo descrito se parece com isto (estrutura ilustrativa, baseada nas capacidades documentadas do modelo, não no prompt exato da Legora, que não foi divulgado):
// Pseudo-fluxo de tie-out, baseado nas capacidades públicas do modelo
// (function calling, structured output, file upload)

1. Upload dos documentos:
   - draft_accounts.pdf
   - trial_balance.xlsx
   - consolidation_schedule.xlsx
   - prior_year_accounts.pdf

2. Instrução ao agente:
   "Para cada valor em draft_accounts, localize o valor
    correspondente em trial_balance e consolidation_schedule.
    Registre cada checagem como um item estruturado:
    { item, valor_relatado, valor_fonte, status, referencia }"

3. Saída esperada (formato estruturado, não texto livre):
   [
     { "item": "Receita - Nota 4", "status": "quebra",
       "detalhe": "gap de 500.000 nao explicado" },
     { "item": "Caixa - Nota 2", "status": "ok" },
     ...
   ]

4. Revisão humana:
   O profissional jurídico confere apenas os itens
   marcados como "quebra", não a lista inteira.
Esse desenho é coerente com o que a documentação técnica do modelo oferece, já que o modelo suporta chamada de função para conectar a ferramentas e sistemas externos, saída estruturada em formatos como JSON, e upload de arquivos para processar documentos e planilhas. Mas vale repetir: isto é uma reconstrução baseada em capacidades documentadas do modelo, não uma descrição do pipeline real da Legora, que a fonte não detalha.
Onde quebra
O primeiro limite é de custo. Com preço de 10 dólares por milhão de tokens de entrada e 50 por milhão de saída, rodar 41 documentos financeiros completos pela janela de contexto não é uma operação trivial em escala. Se sua rotina envolve centenas de fechamentos por mês, o custo por execução exaustiva precisa entrar na conta antes de virar processo padrão.
O segundo limite é de generalização da tarefa. Uma análise crítica do próprio caso, feita por outro veículo, aponta um ponto que a Legora e a OpenAI não escondem, mas também não destacam: quatro erros sintéticos não equivalem a um fechamento de fim de ano bagunçado, com nomenclatura inconsistente. Ou seja, o teste prova que o modelo consegue achar erros plantados deliberadamente para serem encontrados. Não prova, sozinho, que ele lida igualmente bem com a bagunça real de um fechamento contábil de uma empresa com múltiplas moedas, fusões no meio do ano, ou planilhas com convenções diferentes de nomenclatura.
O terceiro limite é de contexto real de uso: o próprio BAR, no conjunto completo de tarefas jurídicas, mostrou ganho médio de apenas 3%. Isso sugere que o salto de 40% no tie-out é o caso mais favorável, não o caso típico. Extrapolar esse número para “o GPT-6 Astra é 40% melhor em tudo” seria um erro de leitura do próprio material fonte.
O que não dá para afirmar ainda
O resumo capturado do artigo da OpenAI é curto, e isso limita o que dá para garantir aqui. Uma análise detalhada do caso, publicada por outro veículo, lista exatamente as lacunas que uma fonte mais completa precisaria fechar: o número de 41 documentos estabelece a escala daquela execução específica, mas não revela a quantidade de páginas, tabelas, imagens escaneadas, jurisdições, moedas ou convenções contábeis envolvidas, e a palavra “minutos” também é subespecificada, podendo descrever tempo de processamento do modelo, tempo decorrido na aplicação, ou o período até uma resposta inicial aparecer.
Também não dá para afirmar, a partir deste material, qual foi o custo total da execução, quanto tempo o revisor humano ainda gastou conferindo o resultado, se houve tentativas anteriores que falharam antes da execução bem-sucedida, ou qual prompt exato e quais ferramentas o agente da Legora usou por baixo do harness. Um benchmark reproduzível divulgaria formatos e contagem total de páginas ou tokens dos documentos, hardware, configuração de API, versão do modelo e limites de contexto, tempo de upload, OCR, recuperação e inferência, templates de prompt, chamadas de ferramenta, tentativas e intervenções humanas, e custo total e tempo necessário para a aprovação profissional final. Nada disso está no resumo que deu origem a este texto, e por isso não afirmamos aqui.
Por fim, o próprio modelo carrega uma ressalva de segurança que a fonte principal não menciona, mas que apareceu em material relacionado da OpenAI sobre o Astra: a empresa sinalizou que uma versão do modelo pode atingir um limiar crítico de capacidade em cibersegurança sob seu framework de preparação. Isso não tem relação direta com o caso de tie-out financeiro, mas é o tipo de contexto que vale mencionar quando se fala do mesmo modelo em outro uso.
Como testar isso você mesmo
Você não precisa da Legora para experimentar a mecânica central do caso, que é usar uma janela de contexto grande para conferência cruzada de documentos. Um caminho pequeno:
- Pegue 3 ou 4 documentos reais e pequenos que você precisa conferir entre si (uma planilha de despesas, um extrato, e um relatório resumo, por exemplo).
- Envie todos juntos em uma única chamada de API para um modelo com janela de contexto grande, pedindo explicitamente uma lista estruturada de divergências, item por item, com a fonte de cada checagem.
- Plante você mesmo um erro proposital em um dos documentos antes de rodar, do jeito que a Legora fez, para ter um critério objetivo de sucesso: o modelo achou ou não achou.
- Compare o tempo e o custo em tokens dessa execução contra o tempo que você levaria fazendo a conferência manualmente, antes de decidir se o fluxo compensa no seu volume de trabalho.
Isso não reproduz o benchmark BAR da Legora, que depende de um harness próprio e milhares de casos acumulados, mas reproduz o núcleo técnico do que foi anunciado: conferência cruzada de múltiplos documentos em uma única passada, com registro auditável do que foi checado.