Dia 16 de outubro de 2026, NVIDIA e AI4Bharat (laboratório do IIT Madras) anunciaram no blog da Hugging Face o Nemotron-pretraining-Indic-v1, um corpus sintético de pré-treinamento para 22 línguas indianas, junto com o pipeline aberto que foi usado para construí-lo. O release vem acompanhado de documentação do NeMo Data Designer, o framework declarativo da NVIDIA para geração de dados sintéticos, e de uma versão específica do pipeline chamada Nemotron Bharat.
Este artigo é sobre o mecanismo: como um documento em inglês vira texto de treinamento em hindi, bengali ou santali passando por tradução, avaliação e reparo. Não é sobre quem está vencendo a corrida de LLM na Índia.
O fato, em números
O corpus tem aproximadamente 2,8 trilhões de tokens, distribuídos em 34 configurações de língua-script. São 2.601,0 bilhões em script nativo e 224,6 bilhões em romanizado (texto índico escrito em alfabeto latino, não tradução para o inglês). Doze línguas têm as duas formas, dez línguas têm só script nativo. A contagem usa o tokenizador do Gemma-4.
Os documentos de origem vêm do Nemotron-CC-v2, de 15 subconjuntos que cobrem web, matemática, código, Q&A e conteúdo especializado. Cada registro de saída preserva o identificador do documento-fonte, o que permite auditar a procedência de qualquer linha gerada.
Como o pipeline transforma inglês em texto índico
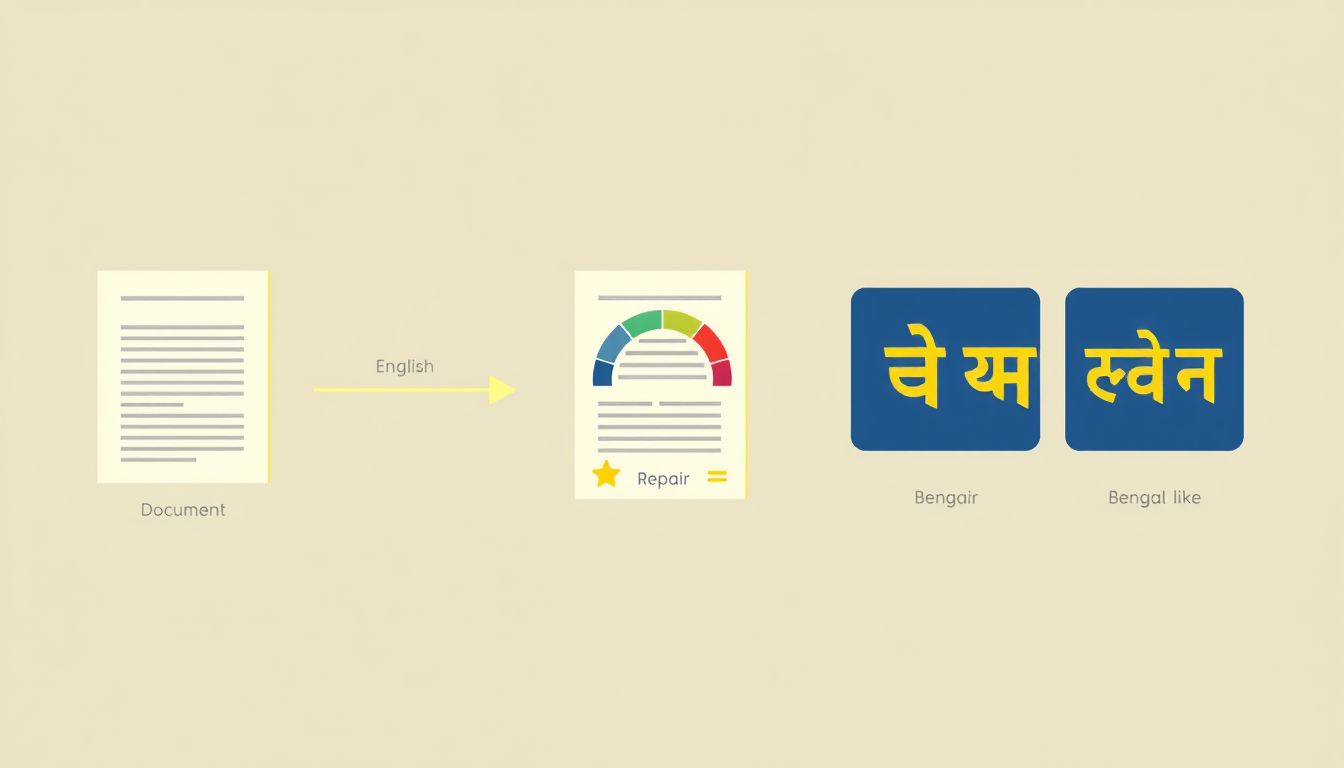
A ideia central do pipeline é simples de descrever e cheia de armadilhas na execução: pegar um documento em inglês, traduzir o documento inteiro (não frase a frase), avaliar a tradução contra o original, e descartar ou reparar o que não passar num limiar de qualidade.
Pensa no que uma editora faz quando contrata tradução técnica. O tradutor entrega o capítulo, o revisor compara com o original, marca onde a tradução perdeu sentido, onde quebrou formatação de código, onde a terminologia escorregou, e devolve pedindo correção. Se o revisor dá nota muito baixa, o capítulo é refeito; se é razoável, vai com ajustes; se é bom, publica. O pipeline faz exatamente isso, só que o tradutor e o revisor são LLMs e a operação roda em escala de bilhões de documentos. Onde a analogia quebra: na editora, revisor e tradutor são pessoas diferentes. Aqui, no fluxo das doze línguas, o mesmo modelo faz tradução e julgamento, o que o próprio relatório admite como limitação.
O fluxo das doze línguas
Para bengali, gujarati, hindi, kannada, malayalam, marathi, nepali, odia, punjabi, tamil, telugu e urdu, o pipeline tem quatro estágios implementados no NeMo Data Designer, usando o Gemma-4-31B-it como motor:
- Tradução documento-a-documento. O modelo recebe o documento inteiro, não frases isoladas. Os prompts separam explicitamente o que deve ser traduzido (prosa) do que deve ser preservado (código, equações, URLs, formatação). Traduzir o documento inteiro, em vez de frase a frase, permite que o modelo use contexto entre parágrafos, tabelas e equações.
- Avaliação contra o original. O mesmo modelo recebe original e tradução, e aplica uma rubrica inspirada em MQM (Multidimensional Quality Metrics). MQM é um framework de avaliação de qualidade de tradução que cobre dimensões como acurácia, fluência, terminologia, convenção local, estilo, verdade, design e internacionalização, usado tanto para tradução humana quanto automática. A rubrica aqui cobre significado, fluência, terminologia, estilo e formatação, e devolve uma nota de 0 a 100 (nota de rubrica, não porcentagem de acurácia).
- Reparo guiado por feedback. Se a nota é abaixo de 75, o próprio feedback da avaliação é usado como entrada para reescrever a tradução, que é reavaliada contra o mesmo limiar. Esse estágio recuperou 438,4 bilhões de tokens que teriam sido descartados.
- Romanização em duas etapas. Para gerar texto índico em alfabeto latino, o pipeline não pede ao modelo “traduza esse inglês direto para hindi romanizado”. Ele pega uma tradução já aceita em script nativo e converte para latino, verificando o resultado contra o nativo. Em comparação humana inicial, essa separação (traduzir primeiro, romanizar depois) produziu menos alucinação e menos inglês residual do que gerar romanizado direto do inglês.
O fluxo das dez línguas
Para assamese, bodo, dogri, kashmiri, konkani, maithili, manipuri, sanskrit, santali e sindhi, o pipeline troca o tradutor. Em vez de Gemma-4, usa o Indic Translate, modelo de tradução documento-a-documento da Bodhan AI (centro sem fins lucrativos incubado no IIT Madras) treinado para inglês e as 22 línguas indianas. O Gemma-4 continua como juiz, mas não há reescrita guiada por feedback; o que não passa dos 75 pontos é descartado.
Dois casos recebem tratamento especial. Documentos longos em santali são traduzidos em janelas sobrepostas e reconstituídos. Para manipuri, a tradução passa primeiro por script bengali e depois é convertida para Meitei Mayek, o alfabeto nativo. Isso dá uma pista do padrão: quando o modelo não lida bem com o script nativo direto, o pipeline inventa uma rota intermediária estável.
Por que o NeMo Data Designer importa aqui
O NeMo Data Designer substitui o acúmulo de scripts e patches por uma declaração estruturada do que cada campo do dataset deve conter, como os campos dependem uns dos outros e quais checagens de qualidade precisam passar antes de um registro ser mantido. Cada coluna é definida declarativamente, com tipos que vão de texto e código a saídas estruturadas, imagens, embeddings e sampleadores estatísticos, e tipos adicionais podem ser introduzidos via plugins. É esse sistema de plugins que permite o Nemotron Bharat existir como extensão: ele adiciona prompts de tradução e avaliação, reescrita opcional baseada em feedback, janelamento de documentos e remapeamento de script, sem mexer no núcleo do framework.
O que isso significa na prática
Carregar uma fatia do corpus para inspecionar é curto. O exemplo abaixo pede o ID do repositório, descobre os splits disponíveis e faz streaming de um registro sem baixar o corpus inteiro:
from datasets import get_dataset_split_names, load_dataset

dataset_id = input("Repository ID from the dataset card: ").strip()
config = "hi-Deva-IN" # hindi em devanagari

splits = get_dataset_split_names(dataset_id, config_name=config)
print("Available splits:", splits)

data = load_dataset(dataset_id, name=config, split=splits[0], streaming=True)
print(next(iter(data)))
Os códigos de configuração seguem o padrão lingua-Script-Regiao. hi-Deva-IN é hindi em devanagari, hi-Latn-IN é hindi romanizado. Para quem for montar um estudo de treinamento, o próprio release recomenda comparar misturas num orçamento fixo de tokens e registrar as proporções natural/sintético e nativo/romanizado separadamente. Também vale lembrar que quando dois registros vieram do mesmo documento-fonte (traduzido para línguas diferentes ou para scripts diferentes), eles não são independentes: montar held-out ignorando isso vaza informação entre treino e validação.
Já publiquei em livros, incluindo a série IA na Prática, sobre pipelines que combinam LLM-como-tradutor e LLM-como-juiz, e a parte que mais engana quem começa é essa: tratar geração e aceitação como um passo só. O plugin do Nemotron Bharat devolve candidatos e notas; a política de filtragem é sua. Se você carregar o corpus e usar direto, está confiando no limiar de 75 que a NVIDIA escolheu para o uso dela. Pode fazer sentido para pré-treinamento geral e não fazer para seu domínio.
Onde o pipeline quebra
A documentação é honesta sobre as limitações, e vale repetir aqui porque elas definem onde não usar como está.
Tradutor e juiz são o mesmo modelo nas doze línguas. Isso é documentado no relatório. Um modelo tende a não enxergar seus próprios erros sistemáticos. A validação por amostragem humana ajuda, mas a cobertura varia por língua.
Deduplicação é por source-ID, não semântica. Dois documentos de origem diferentes que falam a mesma coisa viram dois registros no corpus. Se seu objetivo é diversidade real de conteúdo, você vai precisar de deduplicação semântica por cima.
Tradução não substitui texto nativo. O próprio release diz: tradução amplia acesso ao material-fonte, mas não cobre conhecimento local nem contexto cultural. A recomendação é combinar o corpus com texto índico autoral e avaliar a mistura para o caso de uso.
A rubrica de 75 é um corte de projeto. MQM originalmente é um framework de anotação humana com erros maiores pesando 5 pontos e menores pesando 1 ponto, agregados por dimensão. Aqui a implementação é LLM-como-juiz devolvendo nota direta. Alinhado com o espírito, não com o procedimento canônico.
Os ganhos de benchmark não isolam a contribuição do sintético. O release mostra que o Nemotron 3.5 Super VL ganhou entre 4,98 e 9,82 pontos percentuais em MILU, Indic MMLU-Pro, Indic ARC-Challenge, Indic ARC-Easy e Indic GSM8K depois do estágio de continued pretraining índico. Só que esse estágio usou mistura de sintético e natural. O quanto veio de cada parte não está separado nos resultados publicados.
Para dar contexto do custo de personalização que esse tipo de corpus toca: no Mentezinha, com retrieval por criança em produção no Vertex AI, o que descobrimos é que um índice por usuário multiplica custo de armazenamento e manutenção, e cria a pergunta de quando esquecer. Pré-treinar modelo multilíngue tem o mesmo tipo de pergunta em escala maior: cada língua adicionada é token orçado, dado curado, benchmark avaliado. Não é só “ligar mais uma língua”.
O que ainda não dá para afirmar
O release é um anúncio: o próprio texto diz “releasing soon”. Enquanto escrevo, o dataset card e a licença não estão públicos para inspeção. Então não dá para afirmar qual licença permite qual uso comercial, qual é a divisão exata de splits, nem como o streaming vai se comportar com o volume completo.
Também não há, no material público, estudo controlado isolando a contribuição do corpus sintético nos ganhos de benchmark. O próprio release aponta que esse estudo (misturas de fontes, tamanho do pool sintético, cobertura de script) foi feito só para a primeira passada de dados aceitos nas doze línguas. Avaliar o corpus completo, incluindo as reescritas recuperadas e as dez línguas, é marcado como próximo passo.
E a questão de longo prazo que ninguém respondeu ainda: um modelo pré-treinado em tradução massiva de inglês para hindi aprende hindi, ou aprende “hindi-que-parece-tradução-de-inglês”? Resposta provável: depende da proporção de texto nativo na mistura. Mas isso é hipótese, não resultado publicado.
Como testar isso você mesmo
Um caminho pequeno para começar, assumindo que o corpus já esteja público quando você ler:
- Instale
datasetsda Hugging Face edata-designerda NVIDIA (pip install data-designer). - Carregue uma configuração do corpus em modo streaming (como no snippet acima) e inspecione 50 registros em uma língua que você consiga ler ou que alguém próximo consiga.
- Pegue 5 documentos em inglês do seu próprio domínio (técnico, jurídico, educacional, qualquer coisa que te interesse). Rode o plugin Nemotron Bharat do NeMo Data Designer apontando para esses documentos como fonte, com Gemma-4 ou outro modelo que você tenha endpoint.
- Inspecione o resultado: como ficou código? Como ficou tabela? A terminologia do seu domínio sobreviveu? Chame alguém que fale a língua-alvo nativamente para olhar junto. Essa parte é insubstituível.
- Mude o limiar da rubrica (teste 60, 75, 85) e veja o que entra e o que sai. É assim que você descobre se o corte padrão serve para o seu uso.
Se você sair desse exercício com uma opinião informada sobre em qual estágio o pipeline falha para o seu domínio, aprendeu mais do que lendo qualquer resumo. Inclusive este.