No dia 12 de outubro de 2026 a Microsoft anunciou o Maia 300, terceira geração do seu acelerador de IA próprio. O chip foi apresentado por Scott Guthrie, vice-presidente executivo do grupo de nuvem, e por Mustafa Suleyman, CEO de IA da Microsoft, e cobertos pelo The Verge, pela Techzine e por várias publicações técnicas no mesmo dia. A partir de 2027 o Maia passa a ser o chip de inferência primário dos serviços de IA da Microsoft, com o rollout de produção começando naquele ano.
Este artigo não é sobre a disputa com a Nvidia. É sobre como a arquitetura foi montada e o que ela quebra bem (e mal) na vida real de quem serve modelo.
Os números, antes de entrar no mecanismo
Para fixar o ponto de partida: o Maia 300 traz 288 GB de HBM4, 18 TB/s de banda, até 13,8 PFLOPS em FP4 e usa um design multi-die com dies separados de memória e I/O, fabricado no processo N2P da TSMC. O TDP do SoC é de 950 W, bem acima dos 750 W do Maia 200. Um rack junta 96 aceleradores, 27,6 TB de HBM e cerca de 1,7 PB/s de banda agregada de memória, consumindo 167 kW.
Comparado com a geração anterior, o Maia 200 era monolítico em TSMC N3P, com 10,1 PetaOPS FP4 e 750 W; o 300 passa a multi-chiplet em N2P, chega a 13,8 PetaOPS FP4 em 950 W. O salto bruto de compute é modesto (cerca de 37%). O salto grande está na memória e no empacotamento. É aí que vale olhar.
Como o chip foi montado por baixo do capô
Chiplets: a decisão central
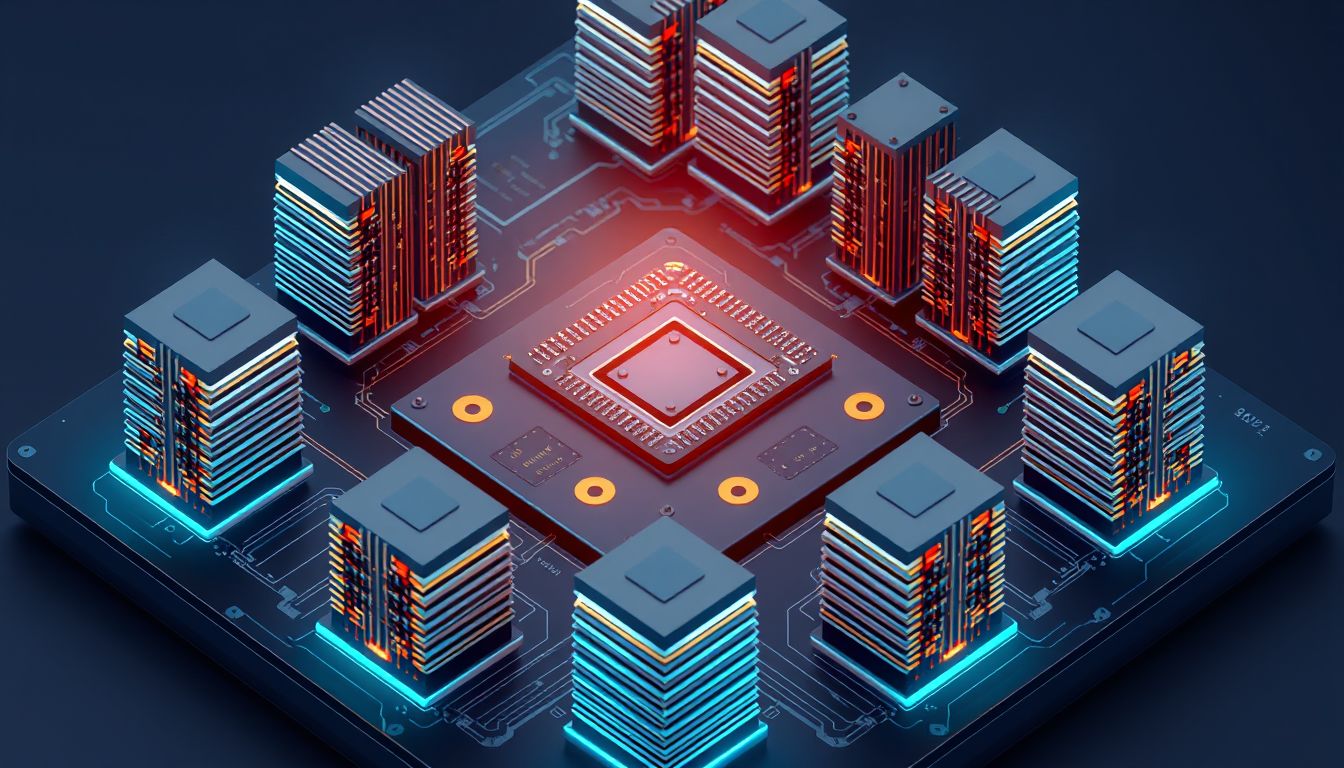
A diferença estrutural em relação ao Maia 200 é o abandono do die monolítico. O Maia 300 é composto por múltiplos chiplets, com peças separadas para compute, controladores de memória e I/O, e os chiplets de compute são fabricados pelo processo N2P da TSMC. De acordo com a Reuters, parte do silício de suporte usa um processo mais barato de 3 nm.
Pensa num restaurante que antes fazia tudo numa única cozinha gigante: fritura, confeitaria, carnes, prep. Dá para fazer, mas qualquer forno quebrado para a casa inteira, e você paga preço de forno top até para fritar batata. Trocar isso por estações separadas (uma com o equipamento caro certo para carnes, outra com fornos simples para pão) é o que a arquitetura de chiplets faz com silício. A analogia quebra num ponto importante: num restaurante o custo marginal de separar cozinhas é baixo; no silício, cada interconexão entre chiplets tem custo real de latência e energia. O ganho só aparece quando o resto do design foi pensado para esse tráfego entre dies.
O ponto prático: nó N2P só vale a pena onde ele muda o resultado, que é o compute denso. Controlador de memória e I/O não precisam disso, e usar nó mais antigo nessas partes aumenta o yield e derruba o custo por wafer. Nas palavras da equipe de infraestrutura do Azure, isso aumenta a área de silício dedicada ao compute e permite que cada função use a tecnologia mais adequada ao seu papel.
HBM4 e o problema real da inferência
Inferência de LLM, principalmente a fase de decode (a geração token a token depois do prompt processado), não é limitada por compute. É limitada por memória. Cada token novo exige ler o KV cache inteiro da camada, e esse KV cache cresce linear com o tamanho do contexto. Modelo com janela de 200k tokens tem KV cache gigante, e o acelerador fica esperando a memória entregar bytes.
É por isso que o número que importa aqui não é o PFLOPS. É o 18 TB/s. Oito stacks de HBM4 entregam 18 TB/s a 950 W de TDP, mais do que o dobro do Maia 200, com só 200 W a mais de consumo. O Maia 200 tinha 216 GB de HBM3e a 7 TB/s. A banda praticamente dobra. Para decode de contexto longo isso é literalmente a diferença entre acelerador ocioso e acelerador ocupado.
SRAM gerenciada por software e MXFP4
Dois detalhes que normalmente passam batido em release de chip, mas que mudam como o compilador trabalha:
- O sistema de memória usa oito stacks HBM4 entregando 18 TB/s em 950 W de TDP, e suporte especializado de kernel trata a SRAM no die como um scratchpad gerenciado por software, para aliviar a pressão sobre a HBM. Isso é relevante porque desloca a decisão de o que fica em cache para o compilador e para a biblioteca de kernels, em vez de uma política fixa de hardware. Quem escreve o kernel ganha controle, e quem não escreve perde performance.
- Suporte a formatos de baixa precisão, incluindo um MXFP4 melhorado, foi desenhado para reduzir a memória e a banda exigidas por compute e armazenamento de KV cache, permitindo janelas de contexto maiores e maior throughput dentro do mesmo envelope de potência. MXFP4 é um FP4 com fator de escala por bloco (microscaling); mantém a dinâmica necessária para pesos e KV cache em 4 bits sem o colapso de qualidade do FP4 puro.
A rede como extensão do dataflow
A arquitetura de dataflow definida por software se combina com otimização de kernel assistida por IA para manter os dados locais, reduzir movimento de dados e aumentar utilização em compute, memória e rede. Em escala de rack, a banda bidirecional de scale-up chega a 3,2 TB/s por acelerador, numa arquitetura de rede Ethernet de duas camadas. A arquitetura técnica descreve superpods de até 128 racks e 12.288 aceleradores.
A escolha de Ethernet, em vez de uma interconexão proprietária estilo NVLink, é consistente: a Microsoft já vinha fazendo Ethernet-based em Maia 100 e 200. O trade-off é claro: você perde a latência cirúrgica do NVLink, mas ganha reaproveitamento de todo o ferramental Ethernet (switches commodities, operação, troubleshooting) e a liberdade de ir até escalas de datacenter sem mudar de tecnologia.
O que isso significa na prática
Para quem serve modelo, o Maia 300 é desenhado para três cargas específicas: raciocínio de contexto longo, conversas sensíveis à latência e tarefas agênticas de múltiplos passos. Vale desdobrar o que isso quer dizer.
Numa plataforma de conteúdo gerado por LLM em escala de catálogo, a conta não é por chamada isolada: é por milhão de tokens de saída por dia, com SLA de latência. Nessa régua, quem decide se o acelerador é bom não é o PFLOPS, é quantos tokens por segundo ele sustenta por watt no seu mix real de tráfego. É por isso que a métrica que a Microsoft escolheu divulgar é essa: a Microsoft espera que o Maia 300 entregue 40% mais tokens por megawatt comparado a sistemas baseados em GPU líderes, e em configuração completa de 96 aceleradores, até 7x o throughput de token em escala de rack do Maia 200.
Tokens por megawatt é a métrica honesta para inferência em produção, porque energia é o que você paga de fato. Se um acelerador faz o mesmo trabalho em 60% da energia, a conta mensal cai 40%, independente de preço de hardware.
Um ponto importante sobre o 7x: é claim da Microsoft, em configuração ideal de rack, contra geração anterior própria. Não é comparação direta contra Nvidia B300 ou TPU v7. É marketing de release. O número útil é o 40% tokens/MW contra GPU, e mesmo esse veio da Microsoft, sem benchmark público reproduzível ainda.
Onde essa arquitetura quebra
Primeiro: isto é um acelerador de inferência. O Maia 300 é desenhado com o que a Microsoft chama de arquitetura inference-first, otimizada para cargas de contexto longo, memory-intensive e decode-heavy. Treinamento continua sendo território de GPU. Se seu caso de uso é fine-tuning pesado ou treino do zero, isto aqui não é para você, e provavelmente nunca será.
Segundo, o óbvio: você não compra Maia 300. Você aluga capacidade no Azure. A partir de 2027, o Maia vira o chip de inferência primário dos serviços de IA da Microsoft. Isso significa Copilot, GitHub Copilot, Foundry e MAI rodando sobre Maia por default. Para quem está fora do Azure, zero impacto operacional. Para quem está dentro, a mudança de hardware deve ser transparente, mas o perfil de latência e custo pode mudar, para cima ou para baixo, dependendo do modelo. Vale medir quando chegar.
Terceiro, trabalhando com agente de código todo dia, com arquivo de contexto em cada repositório, uma coisa fica evidente: na prática, o gargalo raramente é o acelerador. É a janela de contexto que você está dispondo para o modelo. Contexto demais degrada o raciocínio e multiplica custo ao mesmo tempo. Contexto curado ganha de janela grande. O Maia 300 torna barato oferecer contexto maior, o que é bom, mas não resolve o problema de curadoria. Hardware mais rápido não vai consertar prompt mal construído.
Quarto, 950 W por chip e 167 kW por rack. A Microsoft desenvolveu refrigeração líquida dedicada já para o Maia 100, com design que resfria CPU e acelerador em loop fechado. Isso significa que esses racks exigem infraestrutura de datacenter específica. Não é algo que entra no colo em uma sala servidor qualquer. Em escala de hiperescala isso é dado; em qualquer outro contexto é inviável.
O que ainda não dá para afirmar
Benchmarks independentes não existem ainda. Todos os números deste artigo são do anúncio da Microsoft e dos materiais técnicos liberados por ela. Até alguém com acesso a hardware real rodar MLPerf Inference ou carga sintética reproduzível, o 40% tokens/MW é projeção do fabricante, não medição.
Não sabemos o preço, nem o preço efetivo que vai se refletir em API do Azure OpenAI ou Foundry. Eficiência energética não vira preço mais baixo automaticamente; vira margem para o provedor até a concorrência forçar.
Não há detalhe público sobre a stack de software: como o compilador decide o que vai para SRAM, qual o nível de suporte PyTorch nativo, se existe algo equivalente a CUDA kernels de terceiros. Para Maia 100 e 200 havia SDK, Triton e PyTorch, mas não ficou claro ainda o quanto o Maia 300 muda a ABI.
E a comparação direta com Blackwell B300, TPU v7 Ironwood e Trainium 3 na mesma carga ainda está em aberto. Dá para fazer conta de guardanapo com os specs, mas conta de guardanapo em acelerador costuma mentir bastante.
Como testar isso você mesmo
Hardware você não vai testar tão cedo. Mas o mecanismo você pode exercitar hoje, no provedor que já usa:
- Pegue um modelo que você usa em produção. Escolha um prompt representativo com contexto longo (acima de 50k tokens, de preferência).
- Meça tokens por segundo de decode (não o tempo total; separe o tempo até o primeiro token do tempo entre tokens). Essa segunda métrica é o que fica limitado por banda de memória.
- Rode o mesmo prompt com e sem KV cache compartilhado (prompt caching, se o provedor expõe). Veja quanto cai o custo e quanto cai a latência de primeiro token.
- Reduza a precisão quando o provedor oferecer (quantização FP8 ou similar). Compare qualidade da saída numa amostra pequena. Esse é o experimento análogo ao que o MXFP4 do Maia 300 faz por baixo.
O que você vai aprender é onde seu gargalo real está: no modelo, no contexto, na infraestrutura ou na forma como você pede as coisas. Entender isso vale mais do que saber ler spec sheet de qualquer chip.