No dia 2 de outubro de 2026, anteloc publicou no GitHub o projeto ldraw-nova, apresentado como Show HN sob o título Made an open-source Lego AI generator. O release 0.6.0 do ldraw-nova adiciona uma interface web em Docker que permite a agentes LLM produzir modelos LEGO construíveis em formato LDraw, com saídas 3D, VR e Blender. O repositório está sob licença AGPL-3.0 e descreve o projeto como ferramental de agente para construção generativa de modelos LEGO, usando Astra e Opus 5.5, com Jev por trás.
Interessa aqui não o fato de ter LEGO envolvido, mas a arquitetura. É uma das poucas tentativas públicas de fazer um agente projetar um objeto físico passo a passo, usando uma linguagem textual como alvo intermediário. Vou destrinchar como esse pipeline funciona.
O que é LDraw e por que serve de alvo para LLM
LDraw é um formato de arquivo texto para descrever modelos LEGO. Descrever peças e modelos LEGO em um ambiente virtual é um desafio, e em 1995 James Jessiman desenvolveu esse sistema com o programa e formato LDraw. Um arquivo LDraw consiste em um comando por linha, e cada linha de referência de peça traz um padrão bem direto. Pelo exemplo clássico da documentação da comunidade: o primeiro número é o tipo de linha (referência), o segundo é a cor, os três seguintes são a posição, os nove seguintes são a matriz 3×3 de orientação/escala, e o nome .dat ao final é a peça a renderizar naquela posição e orientação.
Ou seja, cada linha é uma instrução de montagem: cor, posição no espaço, rotação, qual peça. É um formato que o próprio autor do ldraw-nova descreve, no post do Hacker News, como uma linguagem assembly, de baixo nível, que descreve como juntar peças LEGO em modelos, uma instrução de posicionamento por vez. E para modelos maiores existe o MPD, que empacota vários submodelos num só arquivo: um arquivo MPD é composto por blocos de código LDraw separados por declarações 0 FILE ou 0 !DATA, cada bloco é considerado um arquivo separado e pode ser referenciado pelos outros.
Esse formato é bom alvo para LLM por três motivos práticos: é texto puro UTF-8, tem gramática mínima (uma linha, uma peça), e existem ferramentas prontas (LDView, LeoCAD, LDCad) que renderizam o resultado sem ambiguidade. O problema é que posicionar peça exige matrizes de rotação e cálculo de coordenadas, e LLM é notoriamente ruim em geometria de precisão.
Como o agente contorna a matemática: plano, gerador, modelo
Aqui está o truque de arquitetura, e é o que faz o projeto ser interessante independente do domínio LEGO. O agente não escreve LDraw direto. Ele escreve um programa Python que escreve LDraw.
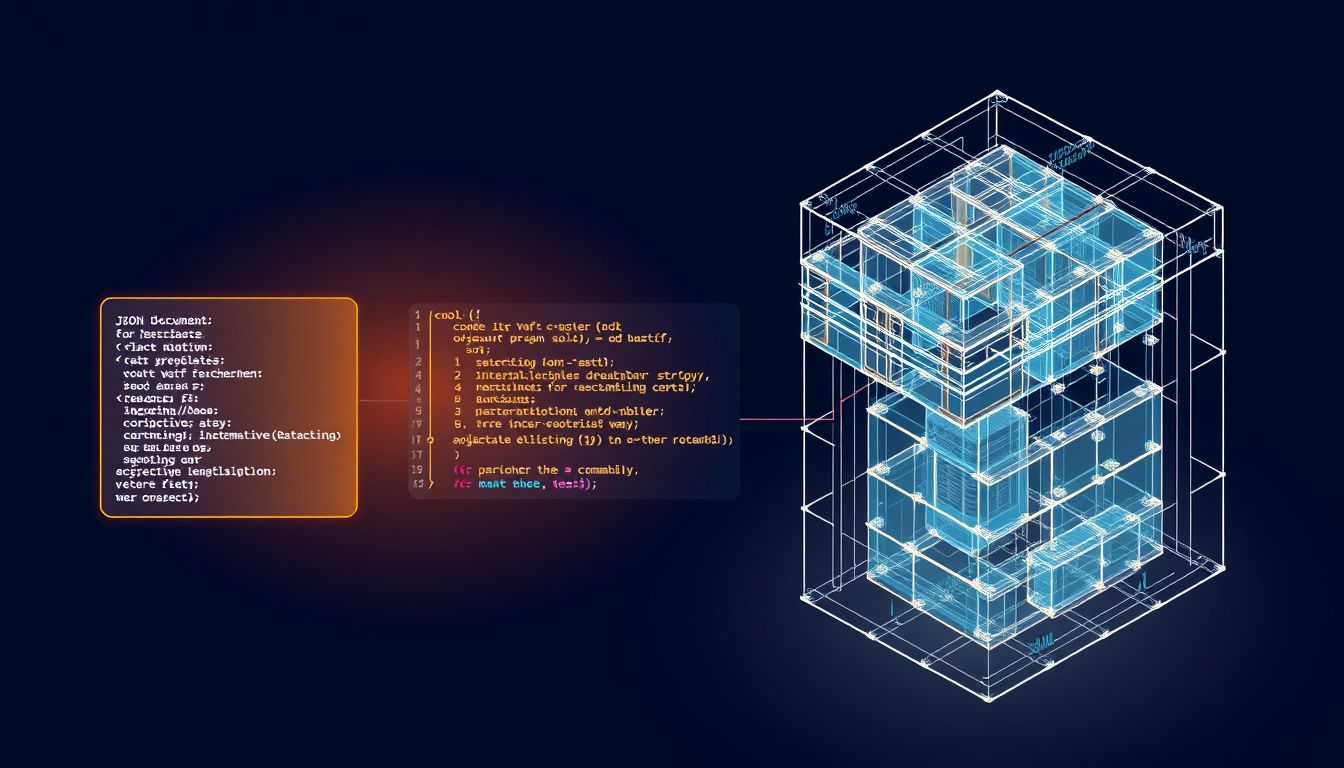
O README é explícito sobre a cadeia: o agente produz um plan.json que descreve o modelo, submodelos e geometria. Com esse plano, ele gera um script generate.py. Esse script, quando executado, produz o arquivo .mpd em linguagem LDraw. O próprio autor compara isso a um compilador em etapas:
agente -> plan.json -> generate.py -> model.mpd
A analogia útil aqui é a de um arquiteto que não sabe desenhar à mão livre. Em vez de desenhar a planta diretamente, ele escreve instruções para um estagiário com régua e esquadro: pegue a peça 3001, gire 90 graus em Y, cole no canto superior esquerdo deste submódulo, repita cinco vezes deslocando duas unidades para a direita. O arquiteto não precisa calcular as coordenadas finais, só descrever a regra. O estagiário (o script Python) resolve a aritmética sem errar casa decimal. A analogia quebra num ponto importante: o estagiário real teria senso espacial e avisaria se duas peças fossem colidir. O script Python só executa, por isso o ldraw-nova precisa de uma camada extra de verificação de colisão, que entra depois.
Por que isso funciona melhor que gerar LDraw direto? O autor registra duas conclusões no README, derivadas de três tentativas anteriores (ldbuilder-ai, py2bricks, py4bricks): a primeira, que dar ao agente ferramental para gerar código Python que produz LDraw contorna a matemática de geometria, porque os modelos vão melhor em gerar código do que em gerar números. A segunda, que agentes aprendem melhor com código Python que produz modelos do que com os modelos em si. Em outras palavras: ele troca o alvo de aprendizado de “saída final” para “programa que gera a saída final”. É a mesma intuição por trás de program-of-thoughts, aplicada a CAD.
O loop de execução do agente
O ciclo descrito no README tem passos definidos:
- O agente recebe um prompt.
- Lê
instructions.mde os documentos de referência sobre a linguagem LDraw e sobre construção de modelos LEGO. - Planeja o modelo: peças necessárias, submodelos, estética.
- Entra num loop iterativo: renderiza imagens do modelo ou submodelo, inspeciona, ajusta posição, volta a renderizar, até considerar que está pronto.
O ferramental auxilia em três frentes: busca de peças adequadas e de modelos de exemplo para começar, detecção de colisões e vãos para checar posicionamento, e renderização headless para o agente ver o que acabou de montar. Esse último ponto é o que fecha o loop. Sem renderização e re-leitura por parte do próprio agente, ele estaria compondo às cegas.
Busca semântica de peças com rerank
A biblioteca oficial de peças LDraw tem milhares de arquivos .dat. Jogar isso tudo no contexto de um LLM é inviável. O ldraw-nova resolve com uma camada de busca. As ferramentas usadas pelos agentes para encontrar peças adequadas e modelos de exemplo tiram proveito do jev-rerank, uma ferramenta de busca semântica com re-ranking apoiada no modelo Jev System One da TypeSafe. Se o usuário tem uma chave TYPESAFE_API_KEY, o rerank funciona; se não, os agentes caem num fallback de FTS (Full Text Search), que pode render modelos piores.
Na prática: o agente descreve em linguagem natural o que precisa (“peça angular de 2×2 para asa de nave”), a camada semântica traz os candidatos mais prováveis, o rerank reordena, e só os top-K entram no contexto do agente. É RAG clássico aplicado a catálogo de peças.
O que isso significa na prática
Para rodar, o fluxo é relativamente direto. Precisa de dois repositórios irmãos: ldraw-nova e ldraw-nova-docker, que traz a configuração Docker e a web app. Clone os dois na mesma tag (atualmente v0.6.0), build do Docker leva um tempo e consome cerca de 5 GB de disco, e sobe com docker compose up -d. A interface responde em https://localhost:8443 (self-signed, necessário para VR no Quest 3) ou em http://localhost:8765.
O que sai do pipeline, segundo o README: código-fonte em LDraw, visualizadores 3D no navegador, interação VR no Meta Quest 3, um arquivo glTF (.glb) editável no Blender com metainformação em Custom Properties, e o histórico completo da conversa e do raciocínio do agente. Esse último item é o que mais interessa para quem quer estudar o comportamento: dá para auditar cada decisão.
Um exemplo de linha LDraw renderizada por um gerador seria assim:
# coloca a peça 3001 (brick 2x4) na cor 4 (vermelho),
# na posição x=0, y=-24, z=0, com matriz identidade
1 4 0 -24 0 1 0 0 0 1 0 0 0 1 3001.dat
O script Python gerado pelo agente emite dezenas ou centenas dessas linhas, com as coordenadas já resolvidas por laços e cálculos no próprio Python, não por o LLM ter adivinhado os números.
A ideia de usar o agente como fonte de código que resolve problemas estruturados tem paralelo em outras áreas. No StartAtende, meu agente de suporte no WhatsApp, o agente não só responde: ele vira fonte de decisão de produto. O ponto comum é tratar a saída do LLM como insumo para um sistema determinístico mais embaixo, não como resposta final.
Onde quebra
O próprio README é honesto sobre as limitações da versão atual, e vale ler com cuidado. VR no Quest 3 tem problemas de manuseio de modelo e de performance. A geração é lenta. Só modelos caros, de ponta, conseguem produzir modelos grandes e corretos, e o autor lista a adaptação para modelos menores (Luna, Haiku) como trabalho pendente. Famílias inteiras de modelos ainda vão mal: naves espaciais geradas não são boas, minifiguras ainda não estão bem suportadas, e a construção a partir de manuais funciona parcialmente, melhor se as páginas do manual forem passadas como imagens.
Tem um ponto que vi comentado em discussões sobre o repositório e que o próprio autor sinaliza: o autor ainda não construiu fisicamente um modelo, atualmente só verifica colisão, não verifica estabilidade física. Ou seja: o fato do software dizer “peça encaixa aqui sem colidir” não significa que o modelo não vai desabar quando montado em peças reais. Validação geométrica não é validação estrutural.
Nenhuma métrica oficial de velocidade ou parâmetros aparece no release inicial, e os números que circulam em discussões externas não são do autor. Nenhuma velocidade ou contagem de parâmetros oficial aparece no release inicial; relatos iniciais mencionam tempos entre 4 e 12 segundos para modelos simples de 50 a 200 peças, mas tratar isso como benchmark seria exagero: são números de usuários, sem metodologia descrita.
Dependência externa importante: a parte interessante da busca de peças depende da API da TypeSafe. Sem a chave, o fallback é FTS, que o próprio autor admite poder piorar os modelos. Então o projeto é open-source, mas o caminho feliz exige uma conta de terceiro.
O que não dá para afirmar ainda
Não dá para dizer que esse mesmo padrão (agente gera gerador em Python que produz artefato final em DSL) funciona melhor que gerar o artefato final direto em todos os casos. O autor afirma isso para LDraw a partir de três tentativas pessoais anteriores, não a partir de estudo controlado. É uma hipótese defensável e intuitiva, mas é hipótese.
Também não dá para afirmar quais prompts rendem quais modelos sem rodar. O repositório lista famílias (veículos, naves, Technic, módulos), mas o grau de sucesso varia por família e por modelo, e o próprio autor diz que naves ainda saem ruins.
Não encontrei na documentação detalhe sobre quais partes exatas do raciocínio ficam no agente e quais ficam no código Python gerado. O README descreve o fluxo em alto nível. Para entender quem faz o quê, é preciso ler o instructions.md e o conteúdo da pasta prompts/.
Como testar isso você mesmo
Caminho mínimo para experimentar sem compromisso:
- Clone os dois repositórios na mesma tag:
git clone --branch v0.6.0 https://github.com/anteloc/ldraw-nova.gite oldraw-nova-dockerao lado. - Reserve 5 GB de disco e rode
docker compose builddentro deldraw-nova-docker. É demorado, deixe rodando. - Suba com
docker compose up -de abrahttp://localhost:8765no navegador. - Antes de qualquer prompt, abra a pasta
examples/do repositório principal e leia um dos arquivos.plan.jsonjunto com ogenerate.pye o.mpdcorrespondentes. É o jeito mais rápido de entender a cadeia plano-gerador-modelo em concreto. - Experimente um prompt simples (um objeto pequeno, uma dúzia de peças) antes de pedir algo grande. Se tiver chave TypeSafe, configure em Settings; se não, aceite que o fallback FTS pode piorar o resultado.
- Depois de gerar, abra o
.mpdno LeoCAD ou LDView para inspecionar. Compare a lista de peças que o agente planejou com o que ele realmente colocou. É aí que se vê onde a validação de colisão pegou e onde deixou passar.
O que vale levar deste projeto, independente de LEGO interessar ou não: usar o LLM para escrever o gerador em vez do artefato é um padrão replicável em qualquer domínio onde o resultado final exige precisão numérica e o processo tem regras bem definidas. CAD é um caso. Infraestrutura declarativa é outro. Vale observar como o ldraw-nova amadurece esse padrão.