Na véspera do DevDay 2026 da OpenAI, começou a circular o nome de um novo produto: um agente persistente, batizado internamente de Aeon (ou possivelmente lançado com o nome público “o”). O que interessa aqui não é o nome nem o marketing. Interessa entender o que muda, na engenharia, quando você sai de um chatbot que responde e para em um agente que continua trabalhando com a aba fechada.
O fato, sem hype
A OpenAI deve apresentar no DevDay 2026, em 29 de setembro em São Francisco (Fort Mason), um agente persistente reportado sob o codinome Aeon e possivelmente com marca comercial “o”. A cobertura veio da Verge, com detalhes técnicos posteriores publicados pelo TestingCatalog, OrcaRouter e CellCog.
O que está publicamente verificado é pouco. Até 24 de setembro de 2026 a OpenAI não tinha anunciado Aeon; até 26 de setembro, o changelog de API, model docs e news feed não continham entrada com esse nome. O que existe são strings de configuração aparecendo brevemente na tela de upgrade do ChatGPT, com “o” como display name e “-o” como sufixo de email. A ideia por trás, entretanto, é concreta e tem literatura técnica sólida: agentes de longa duração, sempre ativos, que rodam em loop no servidor.
Este artigo é sobre esse mecanismo. Não sobre o anúncio.
Como funciona um agente persistente por baixo do capô
A diferença arquitetural com um chatbot
Um chatbot clássico é request-response. Você manda uma mensagem, o modelo produz uma resposta, o processo morre. Um chatbot padrão processa requisições isoladas: responde à sua pergunta e esquece a conversa. Ele não consegue monitorar trabalho em andamento, acompanhar mudanças ao longo do tempo, nem executar ações em sistemas de negócio.
Um agente persistente inverte isso. Ele não espera você abrir o chat. Ele fica rodando, observando gatilhos (email chegou, hora do calendário bateu, arquivo mudou), decide o que fazer, chama ferramenta, olha o resultado, decide de novo. E continua fazendo isso enquanto a tarefa não termina, ou enquanto a política de execução não mandar parar.
Uma analogia útil, e vou marcar onde ela quebra: pense num forno com termostato versus um cozinheiro trabalhando na cozinha. O termostato reage a um evento pontual (temperatura passou do limite, desliga). O cozinheiro tem uma meta (o jantar às oito), consulta relógio, prova a comida, ajusta o fogo, decide se precisa comprar mais um ingrediente. Ele está num loop de percepção, decisão e ação, e o loop só termina quando o objetivo é atingido. A analogia quebra porque o cozinheiro tem um corpo e o agente não: para o agente, “perceber o ambiente” é literalmente ler entradas estruturadas, e “agir” é chamar uma função. Não existe intuição, existe tool call.
O loop de execução
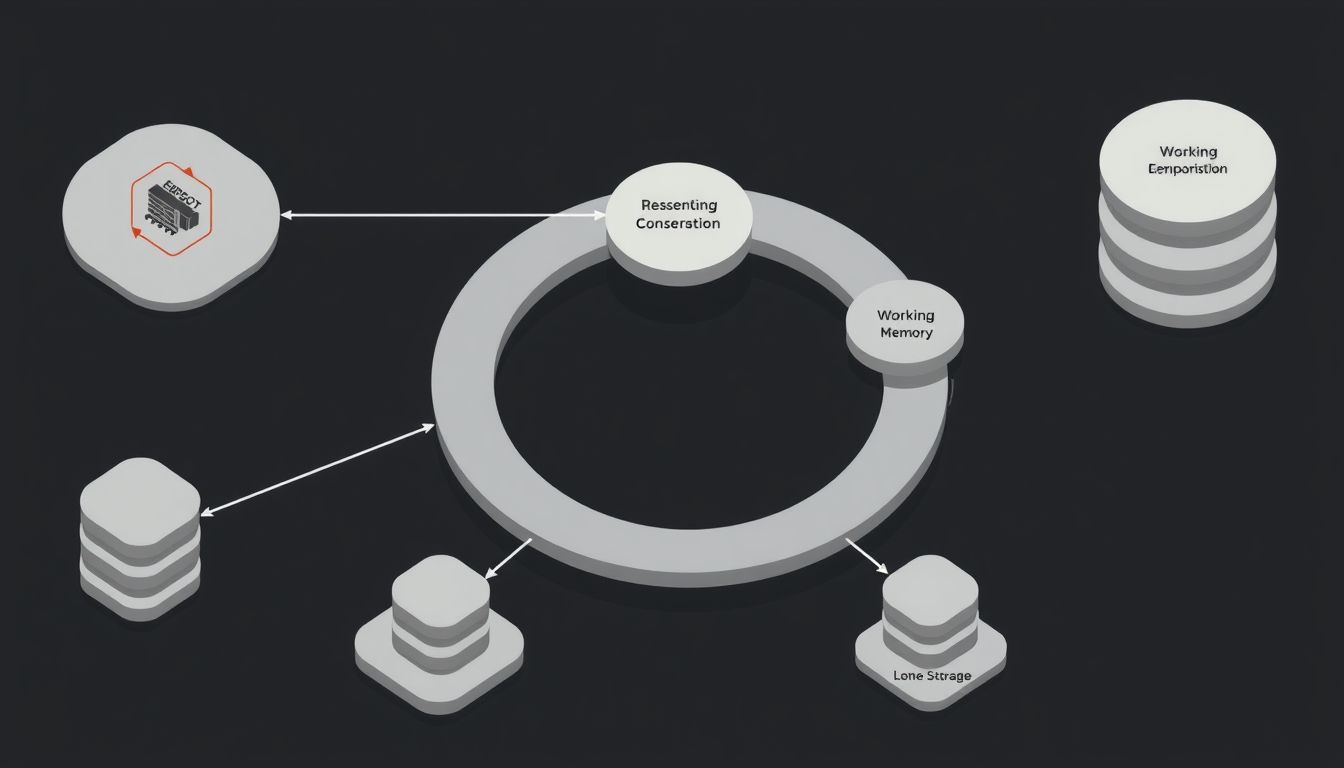
O núcleo de qualquer agente é um loop, geralmente uma variação de ReAct (reason then act). O comportamento em runtime é governado pelo agent harness, a infraestrutura de orquestração que transforma um LLM stateless em um agente persistente, com uso de ferramentas e auto-correção. O loop ReAct fica no centro, cercado pelos subsistemas que o alimentam, restringem e persistem seu trabalho.
Uma iteração típica desse loop faz, em ordem: pré-check e compactação de contexto, pensamento, auto-crítica, ação, execução da ferramenta e pós-processamento. Depois volta para o começo. Isso é o motor. Um agente “sempre ativo” é esse loop rodando num container ou processo que não desliga quando você fecha o browser.
Por que memória vira o problema central
LLM tem context window finita. Se o agente vai rodar por horas, ele vai gerar muito mais texto (pensamentos, saídas de ferramentas, logs) do que cabe no prompt. Um agente de longa duração quase certamente vai exceder a janela de contexto de qualquer modelo atual se tentar manter tudo em memória de uma vez. A solução não é um context window maior, é uma arquitetura de memória.
Na prática, isso vira uma memória em camadas:
- Memória de trabalho: o contexto atual, o que o agente está pensando agora. Gerenciada dentro do prompt e deve ficar enxuta. Só inclui o necessário para o passo atual.
- Memória episódica: um log do que o agente já fez. Em vez de manter saídas completas no contexto, o agente armazena resumos de ações concluídas e seus resultados. Pode recuperar episódios relevantes quando precisar.
- Memória de longo prazo: fatos sobre o usuário, preferências, dados persistidos entre sessões, geralmente em um vector store ou banco relacional.
O trabalho da orquestração é decidir, a cada iteração do loop, o que sobe para a memória de trabalho e o que fica só em episódica. Isso se chama compactação de contexto e é onde muita coisa quebra.
Planner e executor separados
Para tarefas longas, o padrão que aparece na literatura é dividir. A chave é separar o planner do executor. Um componente decide o que fazer, outro faz. Essa separação deixa o planner reavaliar e ajustar sem interromper o trabalho corrente do executor.
Isso importa porque quando um passo falha (a API caiu, o site mudou o layout, o email foi rejeitado), você quer que só o executor daquele passo saiba lidar, sem invalidar o plano inteiro. E quando o plano precisa mudar (surgiu informação nova), você quer que o replan aconteça sem descartar o trabalho já feito.
O harness que segura tudo
O que a OpenAI já expôs publicamente, mesmo antes do DevDay, dá pista da direção. Em 10 de setembro a OpenAI abriu a Agents API em beta público, expondo o harness gerenciado do Codex: a OpenAI roda a orquestração de sessão, compactação de contexto e recuperação, enquanto o desenvolvedor fornece a task, o modelo, as ferramentas e o ambiente de execução, com sandboxes hospedados pela OpenAI, self-hosted, ou em infraestrutura parceira.
Traduzindo: o loop, a memória e o retry ficam do lado deles. Você entrega o quê e as ferramentas. Um agente “consumer” always-on é o mesmo harness com um scheduler na frente e uma UI diferente.
O que isso significa na prática
Um esqueleto minimalista de agente persistente, sem framework, parece com isto:
state = load_state(agent_id) # memoria episodica + plano atual
while not state.done:
 trigger = wait_for_trigger(state) # evento, timer, ou continuacao
 context = build_context(state, trigger) # compactacao aqui
 thought = llm.reason(context)
 action = thought.next_action
 if action.needs_approval:
 request_human_approval(action)
 result = tools.execute(action)
 state = update_state(state, thought, action, result)
 persist_state(agent_id, state)
Cada linha aí esconde uma decisão de engenharia. wait_for_trigger pode ser uma fila, um webhook, um cron. build_context é onde você resolve o problema de memória: quais episódios anteriores entram, quais saem, o que vira resumo. tools.execute roda dentro de uma sandbox com timeouts e limites.
Já usei orquestração desse tipo, escrita na mão, com o mesmo desenho conceitual que a Agents API descreve: sessão, contexto, recuperação, tudo separado da lógica da task. Em um sistema multi-agente de captura e enriquecimento de lead, optei por orquestração explícita em vez de framework, porque quando quebra você precisa saber exatamente qual passo quebrou. O custo é claro: escrever a orquestração na mão custa tempo no começo e devolve em depuração.
O ponto de aprovação humana (needs_approval) merece atenção. A restrição arquitetural é que ações rodam dentro de limites de runtime e de aprovação, não à discrição do modelo. Uma chamada de alto risco, comitar código ou tocar em produção, passa por um gate de aprovação humana antes de executar. Um agente que manda email em seu nome sem gate é um agente que vai mandar email errado eventualmente.
Onde quebra
Custo
Loop rodando é dinheiro rodando. Agentes always-on consomem muito mais recursos de servidor que chatbots request-response. Cada iteração é uma chamada de LLM, e um agente que fica “vigiando” mesmo sem fazer nada relevante gasta tokens em pré-checks e reasoning. Isso pesa na conta e explica por que as strings encontradas descrevem um plano ChatGPT chamado Pro Max a US$ 500 por mês, duas vezes e meia o Pro de US$ 200. Ele parece vender velocidade em vez de mais uso. Sua descrição de uma linha é “Fastest Work and Codex”, e screenshots adicionam memória máxima e 100GB de armazenamento.
Segurança e liability
Se um agente manda email em seu nome contendo um erro, ou pior, compromete você com algo que não pretendia, o quadro de responsabilidade fica complicado rápido. No material da Verge há relato de vulnerabilidade já corrigida em agente concorrente que permitia takeover de conta, e reclamações de usuários sobre exposição de endereço residencial sem permissão. Anedotas individuais são difíceis de verificar, mas a categoria de risco é real: prompt injection via conteúdo lido, exfiltração via ferramenta com escopo largo demais, autenticação delegada que vaza.
Observabilidade fica não-trivial
Um sistema multi-agente planner-executor lida bem com workflows longos e complexos, mas adiciona overhead de coordenação, mais pontos de falha e maior exigência de observabilidade. Um agente que rodou por seis horas e falhou no final precisa ter deixado rastro suficiente para você entender por que. Sem trace estruturado por iteração do loop, você tem um log gigante e nenhuma pista.
Já senti isso analisando texto aberto de avaliação de cliente para decidir feature: quando o sistema produz um número agregado, o caso extremo, que costuma ser o que importa, some. Com agente persistente é a mesma lógica: se você só olha “deu certo/deu errado” ao final, perde o passo específico onde o agente entrou numa espiral.
Quando não vale a pena
Se a tarefa é bem definida, previsível, e cabe num workflow determinístico, não use agente. Um workflow padrão segue uma sequência fixa de passos. Um agente de longa duração é adaptativo, pode decidir, replanejar quando algo dá errado e tomar caminhos diferentes. Workflows são previsíveis, agentes são flexíveis. Você paga a flexibilidade em custo, complexidade e imprevisibilidade. Se você não precisa dela, não pague.
O que não dá para afirmar ainda
Sobre o Aeon especificamente, quase tudo é especulação até a keynote. Detalhes sobre tasks suportadas, permissões, agendamento, memória ou disponibilidade permanecem desconhecidos. O TestingCatalog agora acha que Aeon pode ser o nome interno para os custom agents existentes de Workspace da OpenAI, não do produto novo. O nome público pode ser “o”, pode ser outra coisa, pode não existir ainda no anúncio.
Sobre a arquitetura descrita aqui: ela reflete o consenso técnico atual de como agentes persistentes são construídos, incluindo o que a própria OpenAI expôs na Agents API em beta. Não é especulação sobre o Aeon. É o mecanismo que qualquer produto dessa categoria (Aeon, Muse, Grok Bot, Gemini Spark) precisa implementar de alguma forma. Detalhes proprietários de como a OpenAI faz compactação, escalonamento e sandboxing continuam fechados.
Como testar isso você mesmo
O caminho mais curto para entender agente persistente na prática é construir um pequeno, rodando localmente, sem framework:
- Escolha uma tarefa com trigger claro e passo múltiplo. Exemplo: “a cada hora, olhe minha caixa de entrada, identifique emails que pedem resposta, rascunhe uma resposta e me mostre para aprovar”.
- Implemente o loop principal em Python com três funções:
reason(state) -> action,execute(action) -> result,update(state, result) -> state. - Persista o estado em SQLite. Cada iteração grava thought, action, result. Isso é sua memória episódica e seu trace de observabilidade no mesmo lugar.
- Adicione compactação: quando o contexto passar de N tokens, resuma tudo antes do último passo em uma linha e substitua.
- Coloque um gate humano antes de qualquer ação irreversível (mandar email, gastar dinheiro, apagar arquivo).
- Rode por 24 horas. Leia os logs. Encontre onde ele decidiu errado. Ajuste o prompt do
reasonou os limites doexecute. Repita.
Depois disso, quando algum vendor (OpenAI, Meta, Google) descrever o agente always-on deles, você vai ler a documentação com outros olhos. Vai saber onde perguntar sobre compactação, sobre limite de iteração, sobre gate humano, sobre custo por hora ociosa. É o único jeito de sair do lado espectador dessa discussão.