Detectores de texto de IA que olham palavra por palavra funcionam quase perfeitamente em texto cru saído do modelo, mas quebram assim que alguém reescreve. Um paper de setembro de 2026 propõe olhar para outra camada: não as palavras escolhidas, e sim como o texto é montado. E o resultado se sustenta mesmo depois de reescrita.
O fato
Em 14 de setembro de 2026, Jochen Madler (Sitefire) publicou no arXiv o paper SlopShape: Identifying AI-Generated Commercial Web Content (arXiv:2609.15369). O trabalho replica o método StoryScope (Russell et al., 2026), originalmente aplicado a ficção, sobre 2.250 blog posts humanos anteriores ao ChatGPT de 268 domínios corporativos contra 11.250 versões geradas por cinco modelos de fronteira, e detecta os posts de IA com 98,0 de macro-F1 em empresas fora do conjunto de treino, resultado que praticamente não muda (98,1) quando cada post de IA é reescrito pelo próprio modelo que o gerou.
O StoryScope original havia mostrado que ficção gerada por IA é detectável a partir de escolhas estruturais de discurso sozinhas, com 93,2 de macro-F1, um núcleo pequeno de features, impressões digitais por modelo e histórias humanas ocupando regiões mais raras do espaço estrutural. O SlopShape mostra que a mesma coisa acontece em conteúdo comercial, com sinal ainda mais forte. Código e artefatos estão em github.com/pulse-energy-eu/slopshape.
Como o método funciona
A intuição de todo detector de IA anterior era: LLMs escolhem palavras de um jeito estatisticamente diferente. Isso é verdade e detectável, mas frágil. Passe o texto por outro modelo pedindo para reescrever, e a assinatura lexical vira outra. O que o SlopShape faz é subir um nível: em vez de perguntar “quais palavras aparecem”, pergunta “como esse texto está organizado”.
O instrumento: 214 perguntas sobre a forma do texto
O instrumento é um schema de template comercial de 11 dimensões descoberto de baixo para cima a partir de posts humanos, carregando 214 features validadas. Dessas 214, 187 são puramente estruturais, e são essas 187 que sozinhas dão os 98% de F1. Cada feature é essencialmente uma pergunta fechada sobre o texto: em que ordem aparecem os elementos, o post anuncia sua própria estrutura no começo, existe alegação sem evidência de suporte, a voz é institucional ou individual, o texto termina com um chamado à ação canônico, e assim por diante.
Uma analogia útil: imagine avaliar redações do ENEM sem ler o conteúdo, só marcando num checklist “tem introdução com tese”, “tem três parágrafos de desenvolvimento simétricos”, “tem conclusão que fecha com proposta de intervenção”, “as citações aparecem em posições previsíveis”. Se você marcar todos os itens em quase todas as redações de um grupo, esse grupo compartilha uma forma. A analogia quebra num ponto importante: o ENEM incentiva a forma padrão de propósito, enquanto no SlopShape a forma padrão emerge sem ninguém pedir, e é essa emergência involuntária que denuncia a origem.
O pipeline passo a passo
O fluxo do paper, de dado bruto até classificação:
- Corpus humano: 2.250 posts de blog corporativo capturados no Wayback Machine antes do ChatGPT. Isso garante que nenhum texto humano do treino foi contaminado por LLM.
- Brief: para cada post humano, um modelo extrai um resumo do que aquele post está tentando comunicar (assunto, público, chamada de ação). Esse é o “prompt” que vai para os modelos geradores.
- Espelhos de IA: cinco modelos de fronteira (GPT, Claude, Gemini, DeepSeek, Kimi) recebem o brief e escrevem sua própria versão. Total: 11.250 espelhos.
- Anotação: um LLM avalia cada post, humano ou IA, respondendo às 214 perguntas do instrumento. Cada texto vira um vetor de 214 respostas.
- Classificador: sobre esses vetores, um modelo simples aprende a separar humano de IA, e depois a atribuir cada post ao modelo específico que o gerou.
Por que confiar no anotador que é LLM
Este é o ponto que costuma ser fraco em pipelines assim. Se o anotador é um LLM, ele pode inventar. O paper leva isso a sério. Porque o pipeline é rodado por LLM de ponta a ponta, ele é auditado com corridas de repetibilidade, um filtro de confiabilidade aplicado antes de qualquer rótulo humano ou de IA ser visto, e uma sessão de anotação de ouro humana que supera os números de concordância do original. O instrumento é validado com anotação de ouro humana (kappa humano-humano 0,928, kappa humano-modelo 0,946) e checagens de repetibilidade (alpha de Krippendorff 0,891). Traduzindo: dois humanos anotando o mesmo texto concordam em 92,8%, e o LLM concorda com o humano em 94,6%. O anotador automatizado não está mais divergente do humano do que humanos divergem entre si.
O achado central: dez features carregam quase todo o sinal
O padrão estrutural central é resumido em dez features que carregam 27,6% do total. Ou seja, das 187 features estruturais, um subconjunto pequeno de dez concentra grande parte do poder de discriminação. Os posts de IA compartilham uma forma arrumada e auto-anunciadora, 79,3% são atribuídos à fonte correta contra uma taxa de acaso de 16,7%, e posts humanos ocupam configurações estruturais raras.
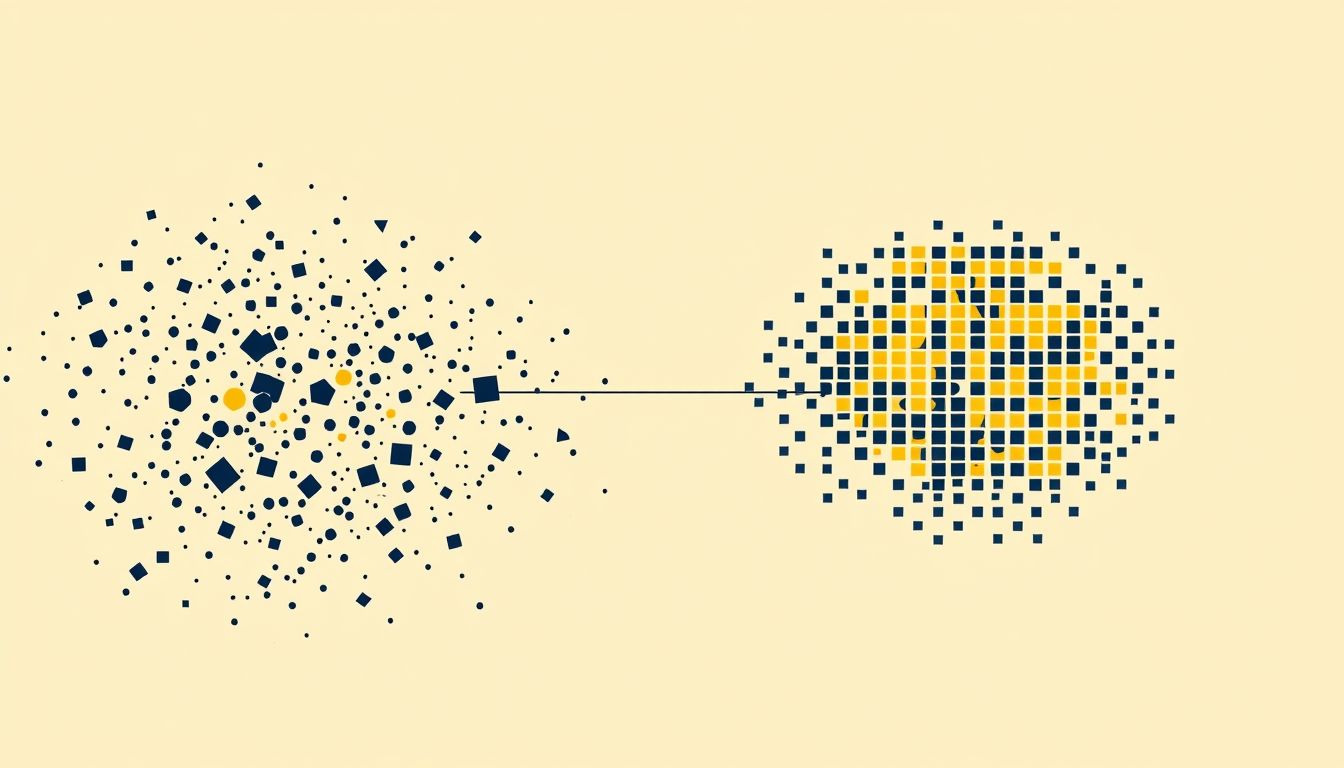
“Auto-anunciadora” é a parte que interessa tecnicamente: o texto de IA tende a dizer no começo o que ele vai fazer, entrega exatamente aquilo, e fecha resumindo o que fez. É a estrutura de uma apresentação de slides transformada em prosa. O gap de raridade também tem uma leitura geométrica: posts humanos estão espalhados amplamente no espaço de features estruturais enquanto posts de IA se agrupam juntos. Se você projetar todos os textos como pontos num espaço de 187 dimensões, os humanos formam uma nuvem dispersa e os posts de IA formam um caroço denso, e o caroço fica no mesmo lugar mesmo quando o modelo reescreve.
O que isso significa na prática
Reescrita é a defesa mais óbvia contra detectores. Você pega o texto, pede para outro modelo reescrever mantendo o sentido, e a assinatura lexical evapora. O SlopShape é imune a isso porque a reescrita não mexe na coluna vertebral do texto: se o post original abre anunciando três benefícios, entrega os três em ordem e fecha convidando ao contato, a versão reescrita quase sempre faz a mesma coisa. As palavras mudam, a forma não.
Isso tem consequência prática direta em duas frentes. Primeiro, sistemas de moderação de conteúdo podem passar a olhar estrutura, não vocabulário. Segundo, quem escreve com IA e quer que o texto passe como humano precisa fazer o que humano faz: quebrar a simetria, não anunciar tudo no começo, deixar afirmações sem prova de apoio quando faz sentido, terminar sem fechar em laço. Reescrever com outro LLM não resolve.
Nos livros que escrevi, entre eles a série IA na Prática, uma coisa que fica clara ao editar texto meu contra texto gerado é exatamente isso: o rascunho de IA tende a fechar tudo, listar tudo, avisar o leitor do que vem. O que quebra a forma é a interrupção humana: um exemplo que não encaixa perfeitamente, um parênteses que sobra, uma frase que corta o parágrafo pela metade. Isso não é estilo, é ruído estrutural, e é isso que o SlopShape está medindo.
Os modelos têm assinaturas diferentes entre si
A raridade média por modelo ordena os modelos de IA como deepseek 0,547 > claude 0,483 > gemini 0,461 > kimi 0,356 > gpt 0,329. DeepSeek fica mais próximo dos humanos, casando com seu status de fonte mais difícil de atribuir, e a checagem com correspondência de tamanho mostra que essa proximidade é estrutural e não devida ao comprimento: a ordenação por modelo se preserva no subconjunto com tamanhos casados. DeepSeek escreve com estrutura menos padronizada. GPT é o mais previsível estruturalmente. Isso é útil se você constrói ferramentas de análise: sabendo qual modelo tende a produzir qual forma, você pode ajustar detecção por origem esperada.
Onde quebra
Três limites concretos.
Um. O paper trata só de blog post comercial B2B em inglês. Não há garantia de que a assinatura estrutural sobreviva em português, em outros gêneros (documentação técnica, e-mail transacional, tweet), ou em conteúdo curto. O modelo estrutural foi induzido a partir desse corpus.
Dois. Há uma crítica metodológica séria no próprio arXiv. A mecânica de espelho é informacionalmente assimétrica. O paper interpreta os valores ausentes como uma preferência de IA por estrutura arrumada e auto-anunciadora, mas uma interpretação igualmente plausível é que os modelos de IA simplesmente não receberam o detalhe contextual necessário para produzir aqueles recursos. O conjunto de features de núcleo não é, portanto, evidência de um estilo distinto de IA sem uma demonstração de que as mesmas features mudam quando modelos de IA recebem briefs mais completos. Em termos práticos: o modelo escreveu com menos informação do que o humano tinha, e talvez parte da diferença seja isso, não a natureza do gerador.
Três. Custo. Anotar um post com o instrumento significa fazer o LLM responder a 214 perguntas sobre ele. Para 13.500 documentos, o paper reporta 148.500 respostas armazenadas mais 15.950 do teste de reescrita. Isso não é um detector barato para rodar em tempo real: é um instrumento de análise, não um filtro de request. Se você quer rodar isso na entrada de um formulário, esqueça. Se você quer rodar sobre um corpus de 5.000 páginas indexadas para auditar, vale.
Analisando texto aberto de avaliação de cliente para decidir feature, aprendi que sentimento agregado esconde o caso extremo, que costuma ser o que importa. O mesmo se aplica aqui: 98% de F1 não significa que os 2% restantes são erros aleatórios. São exatamente os posts humanos com estrutura suspeitamente organizada, e os posts de IA escritos por alguém que quebrou a forma. Um detector estrutural vai errar consistentemente nesses casos, e são os casos onde a decisão importa.
O que não dá para afirmar ainda
Três coisas.
Primeiro, não sabemos se o resultado se sustenta em modelos futuros treinados com consciência desse tipo de detecção. Se um laboratório resolve treinar um modelo para variar estrutura de propósito, o núcleo de dez features pode virar ruído. O paper não testa isso, e não tem como testar sem os modelos.
Segundo, o instrumento foi induzido a partir de posts comerciais em inglês pré-ChatGPT. O schema de template comercial é derivado de três corridas independentes sobre 18 posts humanos cada. Dado o pequeno tamanho da amostra (54 posts humanos), a generalização do schema de 11 dimensões para o corpus completo de 2.250 deveria ser justificada mais explicitamente. A crítica é justa e o autor não responde a ela na v2.
Terceiro, o paper não afirma que essas features capturam “como IA pensa”. Elas capturam como IA escreve conteúdo comercial quando recebe um brief resumido. Extrapolar para “detector universal de texto de IA” é o autor não fazer, e não deveríamos fazer por ele.
Como testar isso você mesmo
Um caminho pequeno, sem replicar o paper inteiro:
- Pegue cinco posts de blog corporativo que você sabe que são humanos e anteriores a 2023 (Wayback Machine ajuda).
- Extraia um brief curto de cada um: assunto, público, três pontos principais, chamada de ação.
- Peça a dois LLMs diferentes para escrever um post a partir de cada brief.
- Monte um checklist de dez perguntas fechadas sobre estrutura, por exemplo:
1. O texto anuncia sua estrutura nos dois primeiros paragrafos? (S/N)
2. Existe simetria numerica entre secoes (mesmo numero de bullets, mesmo tamanho)? (S/N)
3. Cada afirmacao forte vem seguida de evidencia? (S/N)
4. A voz e institucional ou individual? (I/P)
5. O texto termina resumindo o que foi dito? (S/N)
6. Existe exemplo especifico com nome, data ou numero real? (S/N)
7. Aparece uma opiniao que o autor nao defende no proprio texto? (S/N)
8. Existe parenteses ou digressao que nao serve ao argumento central? (S/N)
9. O fechamento contem chamada de acao canonica? (S/N)
10. As transicoes entre paragrafos usam conectores previsiveis? (S/N)- Anote cada um dos 15 textos (5 humanos + 10 de IA) você mesmo, sem saber qual é qual. Depois compare.
Você não vai reproduzir 98% de F1 com dez perguntas manuais e 15 textos, mas vai ver o padrão: os textos de IA tendem a marcar sim nas perguntas 1, 2, 5, 9, 10, e não nas 6, 7, 8. Os humanos ficam bagunçados. Isso é o SlopShape em miniatura, e é o que o instrumento de 187 features está fazendo em escala.
Se quiser ir a fundo, o repositório publica o instrumento completo, os prompts, o código e os artefatos agregados. Respostas de features por documento (148.500, mais 15.950 respostas reescoradas do teste de reescrita), pesos de modelo treinados, briefs (2.250), espelhos (11.250) e os espelhos de teste reescritos (1.450) estão disponíveis para pesquisadores mediante solicitação sob um acordo de pesquisa não comercial. Ou seja: dá para verificar as contas, mas os dados brutos ficam atrás de um pedido formal.